
Monitoring, Incident Management und operative Entscheidungen in KI-gestützten Kernprozessen erfordern eine klare Trennung der Verantwortlichkeiten. Die IT oder ein Managed-Services-Partner muss die technische Systemverantwortung tragen, während die Business Unit für die funktionale Prozessverantwortung zuständig ist. Dadurch konzentriert sich die IT auf die Stabilität der Infrastruktur und die Business Unit auf die Akzeptanz der Prozessergebnisse.
Verantwortung für KI-Kontinuität in Kernprozessen
Der Artikel behandelt die Notwendigkeit eines strukturierten Ansatzes für Verantwortung in KI-gestützten Kernprozessen, bei dem technische und funktionale Verantwortlichkeiten klar getrennt werden.
- Die technische Systemverantwortung muss bei der IT oder einem Managed-Services-Partner liegen, um Infrastrukturstabilität zu gewährleisten.
- Die funktionale Prozessverantwortung muss bei der Business Unit liegen, um inhaltliche Akzeptanzkriterien festzulegen.
- KI-Incident-Management erfordert umfassende Telemetrie, um die Ursache von Qualitätsverschlechterungen nachzuverfolgen.
- Ein klarer Eskalationsweg muss zu Entscheidungen über die Fortsetzung von KI-Prozessen führen.
Wer ist für KI-Kontinuität in Kernprozessen verantwortlich?
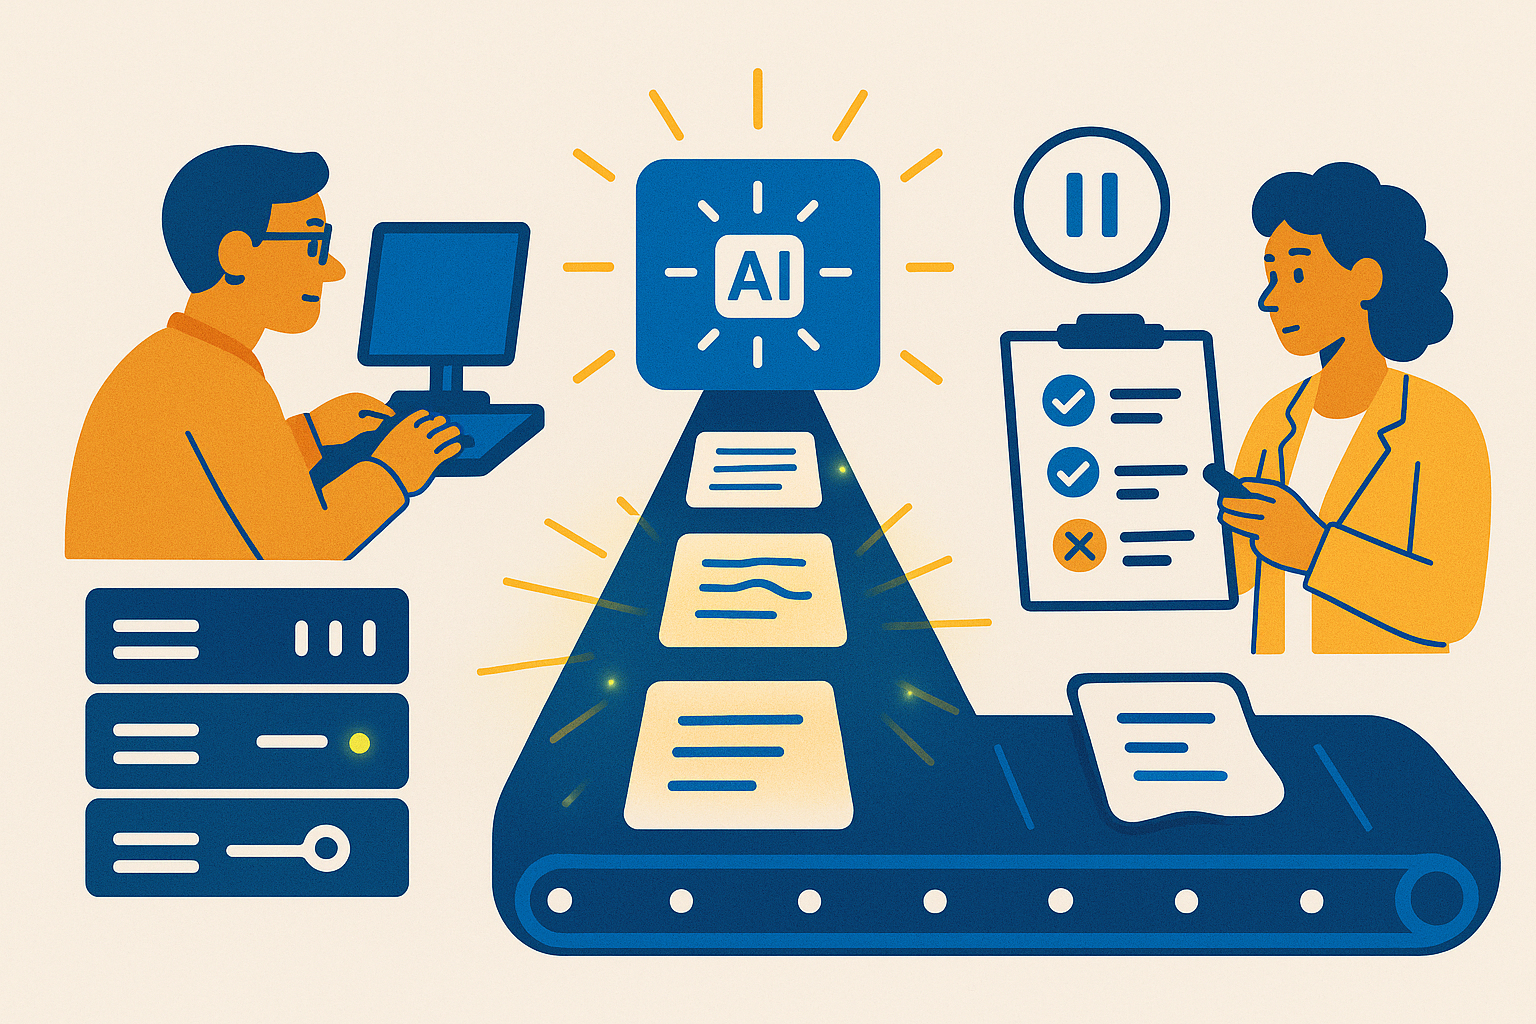
KI-Kontinuität erfordert zwei ausdrücklich getrennte Formen der Verantwortung. Die technische Systemverantwortung liegt bei der IT oder einem Managed-Services-Partner. Dazu gehören die Stabilität der zugrunde liegenden Anwendung und die technischen Signale, die belegen, ob die Lösung erreichbar und ausführbar bleibt. Die funktionale Prozessverantwortung liegt bei der Business Unit, die für das Prozessergebnis verantwortlich ist. Diese Partei bestimmt daher nicht nur, ob ein Ergebnis technisch bereitgestellt wurde, sondern auch, ob dieses Ergebnis inhaltlich innerhalb der vereinbarten Akzeptanzkriterien liegt.
Diese Aufteilung verhindert, dass ein Qualitätsproblem zwischen Teams hängen bleibt. Die IT kann feststellen, dass eine Schnittstelle reagiert und technische Komponenten verfügbar sind, während die Business Unit erkennt, dass die erzeugten Inhalte für den Prozess nicht mehr nutzbar sind. Beide Beobachtungen können gleichzeitig zutreffen. Durch die Trennung der Rollen wird klar, wer welche Frage beantwortet: Die IT behandelt die Stabilität des Systems; die Business Unit akzeptiert, verwirft oder korrigiert die Bedeutung der KI-Ausgabe.
Der Grad der Autonomie bestimmt, wie scharf diese Grenze gezogen werden muss. Wenn die KI ausschließlich Entwürfe liefert, die ein Mitarbeiter prüft, bleibt die menschliche Validierung Teil des Prozessschritts. Wenn die KI selbstständig Transaktionen bucht, sind deutlich strengere programmatische Validierungsebenen und feste Grenzen im Backend erforderlich. Der Business Owner bleibt in beiden Situationen die geeignete Rolle, um die Akzeptanz von Ergebnissen zu beurteilen, doch die Folgen dieser Beurteilung unterscheiden sich erheblich. Bei autonomer Verarbeitung geht es nicht nur um einen falschen Vorschlag, sondern um eine Verarbeitung, die bereits Auswirkungen innerhalb des Prozesses hat.
Daher benötigt ein benannter Business Owner auch eine konkrete Eingriffsbefugnis: Er muss das KI-Subsystem vorübergehend deaktivieren können, wenn die inhaltliche Qualität nicht mehr akzeptabel ist. Dies ist weder eine technische Beurteilung der Ursache noch ein Ersatz für die IT-Verantwortung. Es ist eine Prozessentscheidung, um weitere ungeeignete Ausgaben zu stoppen, während Untersuchung und Wiederherstellung stattfinden. Ohne diese Befugnis kann ein technisch verfügbares System weiterhin unerwünschte Prozessergebnisse erzeugen, weil niemand formell entscheiden kann, den KI-Schritt anzuhalten.
Kontinuität umfasst zudem, was nach der Einführung geschieht. Ein verändertes Eingabeverhalten kann zu Qualitätsverschlechterungen führen, die ohne feste Golden Datasets und automatisierte Regressionstests nicht rechtzeitig sichtbar werden. Der technische Verantwortliche kann diese Kontrollen unterstützen; der funktionale Verantwortliche legt fest, welche Ergebnisse die Referenz bilden und wann eine Abweichung nicht länger akzeptabel ist. So wird Verantwortung mit der tatsächlichen Zuständigkeit für Infrastrukturstabilität und Prozessqualität verknüpft.
Quellen zu diesem Abschnitt: NIST AI Risk Management Framework (AI RMF 1.0)
Warum herkömmliches Incident Management für KI-Workflows nicht ausreicht
Herkömmliches Incident Management ist meist auf technische Abweichungen ausgerichtet, die klar erkennbar sind: ein Fehlerstatus, eine nicht verfügbare Lösung oder eine Verarbeitung, die hängen bleibt. Bei einem KI-Workflow kann die technische Kette jedoch eine erfolgreiche Antwort liefern, während das inhaltliche Ergebnis von dem abweicht, was der Prozess benötigt. Ein HTTP-200-Status besagt dann, dass eine Antwort zurückgegeben wurde, nicht dass diese Antwort inhaltlich korrekt, vollständig oder nutzbar ist. Dadurch entsteht eine andere Kategorie von Incidents: eine stille Qualitätsverschlechterung, die in rein technischen Signalen nicht sichtbar wird.
Ein möglicher Ablauf zeigt, warum dies operativ schwierig ist. Ein externer LLM-Anbieter kann eine Modelländerung vornehmen. Die Integration reagiert weiterhin, doch die Bedeutung der Ausgabe verschiebt sich leicht. Wenn die IT nur HTTP-200-Statuscodes verfolgt, bleibt diese Veränderung unbemerkt. Im beschriebenen Szenario führt dies zu fehlerhaft generierten Mengenrabatten, die in einem ERP-System gespeichert werden. Beschwerden über falsche Rechnungen folgen erst, nachdem die falsche Ausgabe bereits Prozessfolgen hatte. Dann entsteht nicht nur Korrekturaufwand, sondern auch Unklarheit zwischen Operations, IT und dem externen Softwarepartner darüber, wer hätte eingreifen müssen.
KI-Incident-Management benötigt deshalb Informationen, die das technische Ereignis mit dem inhaltlichen Ergebnis verbinden. Für jeden KI-Entscheidungspunkt kann umfassende Telemetrie Payload-Parameter, Prompt-Versionen, Model Embeddings und Confidence Scores erfassen. Bei Qualitätsverschlechterungen ermöglicht diese Erfassung zu untersuchen, ob veränderte Quelldaten, ein externes LLM-Update oder die Integrationslogik der Auslöser ist. Dies ist ein anderer Ansatz, als lediglich festzustellen, dass eine Schnittstelle erreichbar ist: Die Untersuchung konzentriert sich auf die Nachvollziehbarkeit einer Entscheidung, die innerhalb eines Geschäftsprozesses verwendet wurde.
Auch Vereinbarungen über Dienstleistungen verändern dadurch ihren Charakter. Ein Service Level Agreement, das nur Hosting-Uptime behandelt, bezieht sich nicht automatisch auf eine Qualitätsregression von KI-Ausgaben. Für diese Situation können Vereinbarungen neben Verfügbarkeit auch Reaktionszeiten bei KI-spezifischen Qualitätsregressionen, Prompt-Wartung und regelmäßige Bewertungen umfassen. Damit wird vorab festgelegt, dass eine inhaltliche Abweichung als operatives Ereignis behandelt werden kann, auch wenn keine klassische technische Fehlermeldung vorliegt.
Wenn niemand auf Business-Seite befugt ist, die KI-Komponente vorübergehend abzuschalten, kann der Prozess mit abweichenden Ausgaben fortgesetzt werden, während Teams noch untersuchen, was sich verändert hat. Bei falschen Rechnungen summieren sich die Folgen dann, statt dass die Incident Response die weitere Verarbeitung begrenzt.
Quellen zu diesem Abschnitt: NIST AI Risk Management Framework (AI RMF 1.0)
Wann ist Verantwortung für KI-Kontinuität entscheidend?
Der Druck auf die Verantwortungsverteilung steigt, sobald die KI nicht nur einen unterstützenden Vorschlag liefert, sondern ein Glied im Fortschritt eines Kernprozesses bildet. Dies gilt insbesondere, wenn ein Prozess von einem externen KI-Anbieter abhängig wird. Eine Modelländerung oder eine Begrenzung der zulässigen Anzahl von Anfragen kann sich dann unmittelbar auf den Prozess auswirken, wenn keine modulare Abstraktionsschicht oder kein Proxy um öffentliche KI-APIs vorhanden ist. Die Abhängigkeit ist dann nicht nur kommerziell oder technisch; sie bestimmt, ob der Prozess bei einer externen Änderung weiterhin funktionieren kann.
In dieser Situation reicht ein einzelner Verantwortlicher nicht aus. Die Sicherung der Kontinuität beruht auf drei sich ergänzenden Säulen. Die erste ist die deterministische Anwendungsüberwachung von Warteschlangen und API-Gateways. Die zweite ist die probabilistische Qualitätsüberwachung von Datendrift und Extraktionsgenauigkeit. Die dritte besteht aus formalen Eingriffen über Runbooks und Eskalationswege. Diese Komponenten haben unterschiedliche Zwecke: Verfügbarkeit verfolgen, abweichende Ausgaben erkennen und festlegen, wer bei einer Abweichung handelt.
Die externe Abhängigkeit macht diese Dreiteilung sichtbar. Eine technische Störung oder ein Rate Limit kann eine unmittelbare Frage der Verfügbarkeit darstellen. Ein verändertes Modellergebnis kann dagegen technische Erreichbarkeit mit einem weniger nutzbaren inhaltlichen Ergebnis verbinden. Ein Runbook und ein Eskalationsweg verknüpfen beide Situationen mit einer Entscheidung über den Prozessschritt. Dadurch entsteht ein Raum für die Frage, ob die KI-Komponente unterbrochen, untersucht oder wieder in Betrieb genommen werden muss, anstatt lediglich eine Meldung über eine externe API zu erzeugen.
Eine Architektur mit automatisierten Fallbacks kann die Verfügbarkeit des Prozesses unterstützen, wenn sich ein externer Anbieter ändert oder Einschränkungen einführt. Ihre Existenz beseitigt die Frage der Verantwortung nicht. Jemand muss weiterhin entscheiden, welcher Fallback im Prozesskontext akzeptabel ist und wann eine Abweichung als Incident gilt. Gerade wenn die technische Kette Alternativen bietet, bleibt eine formelle Entscheidung über die inhaltliche Akzeptanz erforderlich.
Die Verantwortung verdient daher dort die ausdrücklichste Ausgestaltung, wo Autonomie, externe Abhängigkeit und Prozessfolgen zusammenkommen. Dort berühren sich Anwendungsüberwachung, Qualitätskontrolle und formaler Eingriff; eine unklare Grenze zwischen diesen Verantwortlichkeiten verzögert die Reaktion, wenn die normale Verarbeitung unter Druck gerät.
Quellen zu diesem Abschnitt: NIST AI Risk Management Framework (AI RMF 1.0)
Wichtige Faktoren bei der Verteilung von Verantwortung
Die Verteilung von Verantwortung bestimmt nicht nur, wer eine Meldung erhält, sondern auch, welche Abwägung der Prozess zwischen Verarbeitungsgeschwindigkeit, menschlicher Kontrolle und formaler Änderungsdisziplin trifft. Der nachstehende Vergleich zeigt, welche Konsequenz jede Entscheidung für KI-gestützte Prozesse hat.
| Faktor | Spannungsfeld bei der Entscheidung | Bedeutung für die Verantwortung |
|---|---|---|
| Verarbeitungsgeschwindigkeit | Automatisierte Straight-Through-Processing-Verarbeitung unterstützt einen schnellen Durchlauf. Menschliche Validierungsinteraktionen bei Grenzfällen erhöhen den Kontrollaufwand und die Personalkosten. | Die Rolle, die das Prozessergebnis akzeptiert, muss bestimmen, wann Geschwindigkeit Vorrang hat und wann ein Grenzfall eine menschliche Beurteilung erfordert. Diese Entscheidung ist funktional: Sie betrifft die Akzeptanz der Verarbeitung, nicht nur die Verfügbarkeit der Technik. |
| Kontrolle bei Grenzfällen | Ein menschlicher Validierungsschritt kann abweichende Situationen abfangen, macht die Verarbeitung jedoch weniger ungehindert und erfordert den Einsatz von Mitarbeitern. | Die Verantwortungsverteilung muss festlegen, wer die Validierungsinteraktion durchführt oder akzeptiert und wer befugt ist, die Grenze zwischen automatischer Verarbeitung und menschlicher Beurteilung zu ändern. Andernfalls wird ein abweichendes Ergebnis als technisches Problem behandelt, obwohl die Frage tatsächlich die Prozesskontrolle betrifft. |
| Raum für Experimente | KI lädt zu Experimenten und Innovation ein. In Prozessen mit großen operativen Folgen steht dem Governance-Reibung gegenüber. | Eine formale Rollenverteilung macht sichtbar, wer über Änderungen entscheiden darf, die von einem Experiment in die reguläre Prozessverarbeitung übergehen. Dies schränkt die Nutzung von KI nicht zwangsläufig ein, macht jedoch den Übergang zu einer formal verwalteten Anwendung ausdrücklich. |
| Formale Governance | RACI-Matrizen, Release-Audits und Change Approvals kosten Zeit und fügen Änderungen weitere Schritte hinzu. | Diese Aktivitäten legen fest, wer ausführt, wer die Gesamtverantwortung trägt, wer konsultiert wird und wer informiert wird. Bei KI verhindert dies, dass ein Release oder eine Änderung ohne klar zuständige Partei für die inhaltlichen Folgen in einem Kernprozess landet. |
| Personaleinsatz | Mehr menschliche Validierung reduziert den Grad der automatischen Verarbeitung und verursacht Personalkosten; weniger Validierung verlagert das Gewicht auf automatische Entscheidungsfindung. | Die Verteilung sollte die personellen Konsequenzen sichtbar machen. Die Business Unit trägt die Abwägung über den Einsatz im Prozess, während die formale Governance festlegt, wie sich diese Abwägung auf Änderungen und Kontrollen auswirkt. |
Quellen zu diesem Abschnitt: NIST AI Risk Management Framework (AI RMF 1.0)
Ein praktischer Rahmen für Verantwortung in KI-Prozessen
Ein nutzbarer Rahmen geht von der Unterscheidung zwischen einem technisch grünen Dashboard und einem inhaltlich gesunden Prozess aus. Halten Sie die Rollenverteilung daher in einer RACI-Matrix rund um die KI-Entscheidungspunkte selbst fest und verknüpfen Sie diese Matrix mit einem ausdrücklichen Eskalationsweg. Die folgenden Komponenten geben dieser Verteilung eine operative Form.
- Machen Sie KI-Ausgaben zu einem eigenen Kontrollpunkt in der RACI-Matrix. Herkömmliche Laravel-Anwendungen fallen in der Regel deterministisch aus, etwa durch HTTP-Fehlercodes oder Datenbank-Timeouts. KI-Systeme können probabilistisch und still ausfallen: Eine erfolgreiche technische Antwort kann dennoch halluzinierende oder vom Qualitätsstandard abweichende Inhalte enthalten. Die RACI-Matrix benötigt daher neben Rollen für technische Signale auch Rollen für die Beurteilung inhaltlicher Ausgaben. Damit ist festgelegt, wer für die Bewertung abweichender KI-Ausgaben zuständig ist und wer informiert wird, wenn diese Bewertung zu einem Incident führt.
- Verteilen Sie das Monitoring nach dem, was es tatsächlich nachweisen kann. Die Wetterbericht-Illusion entsteht, wenn Dashboards ausschließlich Serverstatistiken wie CPU, Speicher und HTTP-Status anzeigen. Ein solches Dashboard kann grün bleiben, während der Kernprozess inhaltlich aufgrund unvollständiger oder halluzinierender Antworten scheitert. Im Rahmen erhält das technische Monitoring eine klare Aufgabe: Transparenz über den technischen Zustand zu schaffen. Zusätzlich erhält das Qualitätsmonitoring einen eigenen Verantwortlichen, der feststellt, ob die Ausgabe weiterhin dem Qualitätsstandard entspricht. Diese Trennung verhindert, dass ein grünes technisches Bild als abschließende Bewertung des Prozesses gelesen wird.
- Machen Sie aus dem Eskalationsweg einen Prozessweg, keinen Weiterleitungsmechanismus. Eine inhaltliche Abweichung muss zu einem erkennbaren Weg von der Signalisierung über die Bewertung bis zum Eingriff führen können. Die Matrix benennt, wer bei einem technischen Signal handelt, wer die Prozessqualität bewertet und welche Rolle einbezogen wird, wenn die KI-Ausgabe nicht akzeptabel ist. Eine Eskalation hat dann einen vorab bestimmten Empfänger und einen vorab bestimmten Entscheidungspunkt, statt dass zwischen IT und Business Unit eine offene Frage entsteht, sobald die Folgen sichtbar werden.
- Verknüpfen Sie die Befugnis zur Unterbrechung mit der inhaltlichen Bewertung. Da technische Verfügbarkeit und nutzbare Ausgabe auseinanderfallen können, erfordert ein Qualitätsincident eine formelle Möglichkeit, den KI-Schritt im Prozess zu unterbrechen. Der für die technische Nachverfolgung Verantwortliche untersucht den technischen Kontext; die Rolle, die den inhaltlichen Standard überwacht, entscheidet, ob die KI-Ausgabe weiterhin verwendet werden kann. Dadurch bleibt der Eingriff mit der Qualitätsanforderung des Prozesses verbunden und nicht mit der Frage, ob eine Serverstatistik rot wird.
Quellen zu diesem Abschnitt: NIST AI Risk Management Framework (AI RMF 1.0)
Häufig gestellte Fragen zur Verantwortung in KI-Prozessen
Bei der Wahl zwischen einem externen KI-Dienst und einer maßgeschneiderten Integrationsschicht kehren vor allem zwei Fragen wieder. Die Antworten hängen mit dem gewünschten Grad der Prozesskontrolle und mit den vertraglich festgelegten Regelungen für das Management zusammen.
- Warum kann die IT nicht alleiniger Verantwortlicher sein?
Die IT kann die technische Seite einer Schnittstelle verwalten, aber die Wahl der Integrationsform geht über technische Verfügbarkeit hinaus. Fertige externe SaaS- oder LLM-APIs können eine kurze Time-to-Market bieten. Dem steht gegenüber, dass eine maßgeschneiderte Integrationsschicht in Laravel mehr Datenkontrolle, deterministische Fallback-Kontrolle und Kontinuitätssicherung bieten kann. Die Abwägung betrifft daher auch, welches Ergebnis und welche Unterbrechung des Prozesses akzeptabel sind. Dies sind Fragen, die nicht ausschließlich durch die technische Managementrolle beantwortet werden können. Die Business Unit hat Einblick in die Bedeutung der Ausgabe innerhalb des Prozesses; die IT kann die technischen Folgen der gewählten Integrationsform verwalten. Eine Verteilung der Verantwortung verhindert, dass beide Fragen einer einzigen Rolle zugewiesen werden, ohne dass diese Rolle über alle relevanten Informationen verfügt. - Welche Elemente gehören in ein SLA für einen KI-Prozess?
Die verfügbaren Ausgangspunkte schreiben keine feste Reihe von SLA-Elementen vor. Sie machen jedoch sichtbar, dass ein SLA allein kein Ersatz für eine ausdrückliche Verteilung der Verantwortlichkeiten ist. Bei externer API-Abhängigkeit ist die Unterscheidung zwischen schneller Inbetriebnahme und Kontrolle über die Kontinuität relevant. Nachweisbare Architekturexpertise kann sich in robusten Fallbacks, asynchronen Laravel Queues und Circuit Breakers äußern, sodass der Kernprozess bei Störungen externer APIs operativ bleiben kann. Für vertragliche Vereinbarungen bedeutet dies, dass die Organisation zunächst klar bestimmen muss, welche Kontinuitätsrolle sie bei der gewählten Integrationsform erwartet und wer dafür zur Rechenschaft gezogen werden kann. Ohne diese vorherige Rollenverteilung bleibt ein SLA eine Verfügbarkeitsvereinbarung ohne klare Antwort auf die Frage, wer über die Prozessfolgen entscheidet.
Quellen zu diesem Abschnitt: NIST AI Risk Management Framework (AI RMF 1.0)
Wichtigste Überlegungen zur Verantwortung für KI-Kontinuität
Die Nutzbarkeit eines Verantwortungsmodells zeigt sich nach der Einführung nicht an Funktionsbezeichnungen, sondern daran, ob eine Qualitätsabweichung schnell erkannt, bewertet und begrenzt werden kann. Drei konkrete Prüfkriterien machen sichtbar, ob die dafür erforderlichen Verantwortlichkeiten tatsächlich zugewiesen sind.
- Ist jede Rolle rund um Quelldaten, Monitoring, Incident-Eskalation und Bugfixing ausdrücklich zugewiesen?
Eine konkrete RACI- und Operating-Model-Matrix macht diese Verteilung von Beginn an sichtbar. Dadurch wird zwischen der Partei, die Quelldaten verwaltet, der Partei, die Signale verfolgt, der Rolle, die bei einem Incident eskaliert, und der Partei, die einen Fehler behebt, unterschieden. Das Modell verhindert nicht, dass Abweichungen auftreten, begrenzt jedoch die Zeit, die bei der Bestimmung verloren geht, wer die nächste Handlung ausführen darf oder muss. Für den Business Owner wird damit auch deutlich, wo die eigene Verantwortung beginnt und endet. - Bietet das Monitoring dem Business Owner ausreichende Transparenz über das Prozessergebnis?
Integrierte Management- und Observability-Dashboards können Echtzeit-Einblicke in Tokenbudgets, Fehlermargen, Reaktionszeiten und Audit Trails von Eingaben und Ausgaben liefern. Diese Kombination unterstützt ein Gespräch sowohl über Kosten und technische Durchlaufzeit als auch über die Nachvollziehbarkeit dessen, was die KI-Komponente verarbeitet hat. Ein Dashboard ist dabei kein Ersatz für einen Verantwortlichen; es liefert die Informationen, mit denen dieser Verantwortliche feststellen kann, ob eine Abweichung operative Folgen hat. - Führt ein Incident-Weg zu einer Entscheidung, die weitere Folgen begrenzen kann?
Ein Eskalationspfad hat erst dann Wert, wenn er mit einer Rolle verbunden ist, die über eine konkrete Befugnis verfügt. Der Weg muss daher neben der technischen Nachverfolgung der Ursache und dem zugewiesenen Bugfixing zu einer Entscheidung über die Fortsetzung des KI-Schritts führen. Dies verknüpft die RACI-Verteilung mit dem täglichen Management: Quelldaten, Signalisierung, Bewertung und Wiederherstellung werden nicht als getrennte Aktivitäten behandelt. Wenn dieser Entscheidungspunkt fehlt, können fehlerhafte Ausgaben weiterhin finanzielle oder operative Folgen verursachen, während Teams noch klären, wer verantwortlich ist.
Quellen zu diesem Abschnitt: NIST AI Risk Management Framework (AI RMF 1.0)
