
Eine stabile verwaltete Einführung für KI-gestützte Prozesse erfordert einen Parallelbetrieb, bei dem die KI-Anwendung neben dem Legacy-Prozess läuft. Dies ermöglicht die Validierung von Zuverlässigkeit, Softwareintegration und Nutzerakzeptanz, ohne operative Instabilität zu verursachen. Der Einsatz getrennter Queues in einer Laravel-Architektur verhindert, dass Produktionsdatenbanken verunreinigt werden.
Verwaltete parallele Einführung für KI-Prozesse
Bei der Einführung von KI in operative Prozesse ist eine verwaltete parallele Einführung entscheidend, um Risiken zu minimieren und Zuverlässigkeit zu gewährleisten. Dieser Artikel erläutert die Notwendigkeit eines Parallelbetriebs und die damit verbundenen Bewertungskriterien.
- Die parallele Einführung verhindert Störungen, indem KI zunächst im Shadow-Modus mit Live-Daten getestet wird.
- Zuverlässigkeitsschwellen bestimmen, welche Transaktionen direkt oder mit menschlicher Verifizierung verarbeitet werden.
- Messbare Abbruchkriterien und Abstimmungsberichte verhindern einen endlosen Shadow-Prozess.
- Circuit Breaker und Fallbacks gewährleisten Kontinuität bei API-Ausfällen.
Warum eine verwaltete parallele Einführung für KI-Prozesse entscheidend ist
Eine parallele Einführung ist kein Selbstzweck, sondern eine vorübergehende Steuerungsmaßnahme, wenn ein KI-gestützter Prozess neben einer bestehenden Arbeitsweise bewertet werden muss. Die Kernfrage lautet nicht nur, ob die neue Verarbeitung Ergebnisse erzeugt, sondern auch, ob diese Ergebnisse im täglichen Kontext nutzbar bleiben, in dem Mitarbeitende Entscheidungen treffen, Ausnahmen bearbeiten und bei Bedarf manuell eingreifen. Ein verwalteter Ansatz ermöglicht diesen Vergleich, ohne die bestehende Arbeitsweise unmittelbar zu ersetzen.
Die Form des Parallelbetriebs hängt vom Prozess ab. Bei stark deterministischen Transaktionen mit eindeutigen Geschäftsregeln kann ein kurzer paralleler Zeitraum von zwei bis vier Wochen mit automatisiertem Vergleich von Abweichungen ausreichen. Hier liegt der Schwerpunkt auf nachweisbaren Unterschieden zwischen dem bestehenden und dem neuen Ergebnis. Bei kontextabhängigen Prozessen reicht diese begrenzte Prüfung nicht aus. Dort können Umstände, Interpretation und menschliche Korrekturen mitbestimmen, ob ein Ergebnis operativ akzeptabel ist. Eine längere Validierung mit Human-in-the-Loop schafft dann Raum, um zu erkennen, welche Fälle einer Prüfung bedürfen und wie Mitarbeitende reagieren, wenn der neue Weg abweicht.
Auch die Wahl zwischen passiver und aktiver paralleler Verarbeitung hat Folgen für die Unterstützung während des Übergangs. In einem passiven Shadow-Modus wird der neue Weg mitgeprüft, ohne den Arbeitsalltag zusätzlich zu belasten. Das begrenzt die vorübergehende Störung, zeigt jedoch nicht, wie sich Nutzerverhalten und manuelle Overrides in der Praxis auswirken. Ein aktiver Parallelbetrieb macht diese Akzeptanz hingegen sichtbar. Dem steht gegenüber, dass Mitarbeitende vorübergehend zusätzliche Disziplin benötigen, weil die alte und die neue Arbeitsweise parallel Aufmerksamkeit erfordern.
Ein unverwalteter Übergang macht gerade diese Unterschiede unsichtbar. Gibt es keinen abgegrenzten Zeitraum, keine gewählte Prüfungsform und keine Begleitung bei Abweichungen, wird eine vorübergehende Sicherheitsvorkehrung schnell zu einer unklaren Doppelung von Arbeit. Dann bleibt unklar, ob ein Unterschied aus einer eindeutigen Regel, einem Kontext mit erforderlichem menschlichem Urteil oder einer Änderung der Arbeitsweise resultiert. Ein verwalteter Parallelbetrieb hält den alten Weg als Vergleichspunkt verfügbar und macht zugleich deutlich, welche Form der Validierung zum jeweiligen Prozesstyp passt.
Quellen zu diesem Abschnitt: Continuous Delivery and Operational Release Patterns
Die Herausforderungen bei der Einführung von KI in operative Prozesse
Die Einführung von KI in einen bestehenden operativen Prozess bringt Unsicherheit in Phasen, in denen die Organisation gerade einen vorhersehbaren Durchsatz und stabile Servicelevels benötigt. Dies gilt besonders, wenn die Auslastung nicht gleichmäßig verteilt ist. Ein Testzeitraum, der nur ruhige Tage umfasst, bietet keine verlässliche Grundlage für einen Weg, der auch bei Spitzenlast funktionieren muss. Seltene Ausnahmen können dann unbeachtet bleiben, obwohl gerade diese Fälle den Übergang unter Druck setzen.
Bei saisonalen Lastspitzen erfordert ein Parallelbetrieb daher einen vollständigen Zyklus, damit die neue Verarbeitung unter den relevanten Schwankungen bewertet wird. Ist es nicht sinnvoll, auf diesen Zyklus zu warten, kann eine erneute Einspeisung historischer Queues eingesetzt werden, um Ausnahmefälle erneut durch die vorgesehene Verarbeitung laufen zu lassen. Beide Ansätze verfolgen dasselbe Ziel: Die Bewertung soll nicht auf die Durchschnittssituation beschränkt werden, sondern auf der Belastung und den Ausnahmen beruhen, die der operative Prozess tatsächlich aufweist.
Die Unterstützung in dieser Phase betrifft mehr als die Verfügbarkeit bei einer Störung. Die Einrichtung muss auch auffangen können, dass eine externe API vorübergehend nicht verfügbar ist. In einer Laravel-Umgebung können Redis- und Horizon-Queues, konfigurierte Circuit Breaker und deterministische Fallbacks hierfür eine kontrollierte Grundlage bilden. Der Fallback bietet in diesem Fall einen vorab festgelegten Ausweichweg statt einer improvisierten Reaktion in dem Moment, in dem die Abhängigkeit ausfällt. So bleibt die parallele Bewertung möglich, ohne dass ein vorübergehender API-Ausfall unmittelbar den gesamten Übergang bestimmt.
Die operative Unsicherheit besteht somit in zwei Richtungen. Einerseits muss die neue Verarbeitung mit repräsentativen Spitzenlasten und Ausnahmen konfrontiert werden. Andererseits muss die Umgebung einem Ausfall einer Abhängigkeit während dieser Bewertung standhalten. Eine KI-Integration, die diese Umstände nicht berücksichtigt, kann in einem begrenzten Test überzeugend wirken, lässt jedoch Fragen über ihr Verhalten offen, wenn die Arbeitslast steigt oder ein angebundener Dienst ausfällt. Die erforderliche Unterstützung verbindet daher eine Prüfung, die die gesamte Prozessvariation abdeckt, mit einem technischen Auffangweg für Störungen in der Kette.
Quellen zu diesem Abschnitt: EU AI Act: Requirements for High-Risk and Operational AI Systems
Wann ist eine parallele Einführung erforderlich?
Eine parallele Einführung bietet sich an, wenn der neue KI-Weg gleichzeitig mit dem bestehenden Weg bewertet werden muss, ohne Produktionsdaten zu vermischen. Dies ist insbesondere dann der Fall, wenn die Folgen eines abweichenden Ergebnisses nicht losgelöst von der Transaktion betrachtet werden können, auf die es sich bezieht. Die Frage lautet dann nicht nur, ob der neue Weg technisch mitläuft, sondern ob er kontrollierbar neben der bestehenden Verarbeitung bestehen kann.
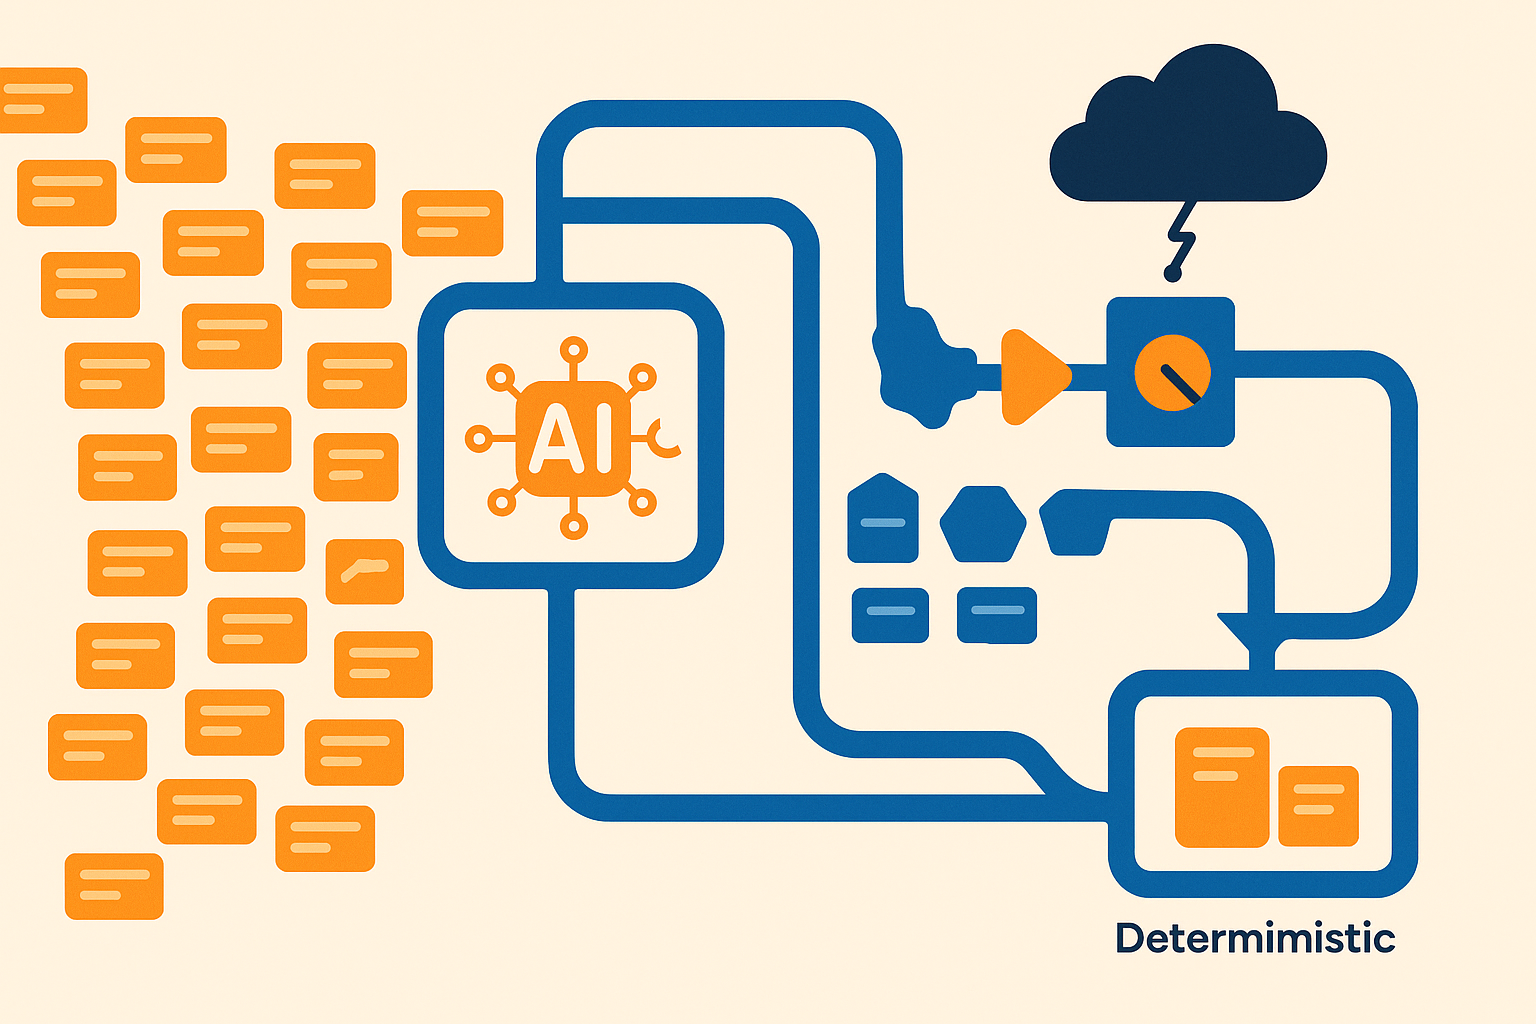
Für diese Situation ist eine entkoppelte individuelle Laravel-Architektur mit getrennten Queues für Live- und Shadow-Transaktionen erforderlich. Die Live-Queue behält die reguläre Produktionsverarbeitung bei. Die Shadow-Queue ermöglicht eine separate Bewertung. Durch diese Trennung wird Parallelbetrieb möglich, ohne Produktionsdatenbanken zu verunreinigen. Diese Unterscheidung bestimmt, ob die Organisation neue Ergebnisse untersuchen kann, ohne die bestehende administrative Realität zu verändern.
Ein zweiter Hinweis ist die Notwendigkeit, im Nachhinein für jede Transaktion rekonstruieren zu können, warum ein Ergebnis entstanden ist oder warum ein Mitarbeitender davon abgewichen ist. Transparente Protokollierung und Audit Trails können dabei Prompt-Snapshots, Modellversionen, Zuverlässigkeitsbewertungen und dokumentierte Begründungen für Overrides festhalten. Diese Daten machen aus einem Parallelbetrieb keinen allgemeinen Versuch, sondern einen überprüfbaren Zeitraum, in dem einzelne Unterschiede nachvollziehbar bleiben.
Parallelbetrieb ist daher erforderlich, sobald Bewertung, Isolierung und Nachvollziehbarkeit gleichzeitig benötigt werden. Ohne getrennte Verarbeitung besteht das Risiko, dass ein Shadow-Weg die Produktionsdatenbank beeinflusst. Ohne Audit Trail bleibt eine Abweichung ein isoliertes Signal, das nicht pro Transaktion eingeordnet werden kann. Für Prozesse, bei denen Kontext oder Überprüfbarkeit eine Rolle spielen, markiert diese Kombination die Grenze zwischen einem begrenzten technischen Test und einem kontrollierbaren Übergang zum Live-Einsatz.
Quellen zu diesem Abschnitt: Continuous Delivery and Operational Release Patterns, EU AI Act: Requirements for High-Risk and Operational AI Systems
Wichtigste Bewertungskriterien für eine parallele Einführung
Die Entscheidung für eine parallele Einführung erfordert Kriterien, die sowohl die vorübergehende Belastung als auch die Unterstützung nach der Inbetriebnahme sichtbar machen. Die folgenden Punkte unterscheiden einen schnellen Übergang mit konzentriertem Risiko von einem kontrollierten Zeitraum mit expliziter operativer Absicherung.
| Bewertungskriterium | Was wird bewertet? | Bedeutung für die Einführungsentscheidung |
|---|---|---|
| Konzentration des Ausfallrisikos | Bei einem Big-Bang-Übergang verlagert sich der gesamte Übergang auf einen einzigen Zeitpunkt. Dieser Ansatz kann unmittelbar theoretische Kosteneinsparungen bringen, konzentriert aber auch das Ausfallrisiko auf diesen Zeitpunkt. | Wenn ein Ausfallzeitpunkt nicht akzeptabel ist, bietet ein verwalteter Parallelbetrieb eine andere Risikoverteilung: Der bestehende und der neue Weg existieren vorübergehend nebeneinander, statt dass eine einzige Umschaltung alles bestimmt. |
| Vorübergehender operativer Mehraufwand | Paralleles Arbeiten erfordert über einen begrenzten Zeitraum doppelte operative Aufmerksamkeit. Dieser Mehraufwand ist der Preis dafür, die beiden Wege nebeneinander bewerten zu können. | Die Organisation wägt die vorübergehende Zusatzbelastung gegen die Möglichkeit ab, Risiken nicht auf einen einzigen Übergangszeitpunkt zu konzentrieren. Dieses Kriterium verhindert, dass allein die unmittelbare theoretische Einsparung als Ausgangspunkt dient. |
| Monitoring der Modellverschlechterung | Die Verwaltungsfunktion verfolgt, ob sich die Leistung des Modells während und nach dem Übergang verschlechtert. Dies ist neben dem regulären Anwendungsmanagement ein eigenständiger Schwerpunkt. | Ein Parallelbetrieb gewinnt an Bedeutung, wenn das Monitoring Teil der Unterstützung ist. Ohne diese Rolle bleibt unklar, wer Veränderungen in der Leistung erkennt, nachdem der neue Weg operativ genutzt wird. |
| Reaktion auf Vorfälle | Ein multidisziplinäres lokales Managed-Services-Team kann die Reaktion auf Vorfälle mit proaktivem Monitoring und regulärem Anwendungsmanagement verbinden. | Die Einführung ist besser abgegrenzt, wenn klar ist, wie ein Vorfall behandelt wird und wie diese Reaktion zum Management der Anwendung steht. Dadurch wird der Übergang auch organisatorisch überprüfbar. |
| Regelmäßiges Prompt-Retuning | Die Unterstützung umfasst in dieser Einrichtung neben der Reaktion auf Vorfälle auch regelmäßiges Prompt-Retuning. | Dieses Kriterium unterscheidet eine einmalige Implementierung von einer Verwaltungsstruktur, die Anpassungen während der frühen Produktionsnutzung berücksichtigt. |
Quellen zu diesem Abschnitt: EU AI Act: Requirements for High-Risk and Operational AI Systems
Ein strukturierter Ansatz für Entscheidungen zur parallelen Einführung
Ein nutzbarer Ansatz gestaltet den Parallelbetrieb als Abwägung zwischen Geschwindigkeit und Kontrolle für jeden Ergebnistyp. Der nachstehende Ablauf konkretisiert diese Abwägung, ohne vollständige Autonomie als Standardausgangspunkt zu setzen.
- Bestimmen Sie, welcher Weg die menschliche Verifizierung beibehält. Vollständige KI-Autonomie maximiert die Verarbeitungsgeschwindigkeit, doch die Auswirkungen von Fehlern in Edge Cases werden größer, da keine zwischengeschaltete Prüfung erfolgt. Eine Human-in-the-Loop-Zwischenschicht behält die menschliche Kontrolle über Fälle bei, die dafür Anlass geben. Dies ist keine generelle Bremse für den KI-Einsatz, sondern eine Abgrenzung dessen, wo autonome Verarbeitung passt und wo ein Mitarbeitender Teil der Verarbeitung bleibt. Die parallele Phase schafft Raum, diese Grenze sichtbar zu machen, bevor der neue Weg die bestehende Arbeitsweise ersetzt.
- Verknüpfen Sie Zuverlässigkeitsschwellen mit dem Behandlungsweg. Zuverlässigkeitsschwellen unterscheiden zwischen Ergebnissen, die über den KI-Weg weiterverarbeitet werden können, und Ergebnissen, die zur menschlichen Verifizierung gehen. Somit wird nicht jede Transaktion auf die gleiche Weise behandelt. Die Organisation kann beurteilen, ob die gewählten Schwellen für abweichende oder weniger sichere Fälle ausreichend Kontrolle bieten. Anstelle eines abstrakten Urteils über die KI-Lösung entsteht eine operative Aufteilung: Welche Ergebnisse folgen dem schnellen Weg und welche bleiben unter expliziter menschlicher Prüfung?
- Wägen Sie die zusätzliche Verifizierungszeit gegen die Fehlerauswirkung ab. Die Human-in-the-Loop-Zwischenschicht erfordert einen Bruchteil zusätzlicher Verifizierungszeit. Dem steht maximale Kontrolle bei Edge Cases gegenüber, gerade dort, wo vollständige Autonomie die Folgen von Fehlern vergrößert. Die Einführungsentscheidung wird damit nicht zur Wahl zwischen ausschließlich Geschwindigkeit oder ausschließlich manueller Arbeit. Sie wird zu einer gezielten Entscheidung darüber, wo die begrenzte zusätzliche Zeit eingesetzt wird, um die Auswirkungen von Ausnahmen zu begrenzen.
- Richten Sie die Verarbeitung so ein, dass die Wege getrennt behandelt werden können. Laravel bietet Queues, Worker und Event Handling als Bausteine für eine getrennte Verarbeitung. In einer parallelen Einrichtung unterstützt diese Trennung die Unterscheidung zwischen einem Weg mit operativer Wirkung und einem Weg, der bewertet wird. So können die Kontrollebene und der Verarbeitungsstrom als getrennte Komponenten organisiert werden, passend zu den gewählten Schwellen und der menschlichen Einbindung.
- Beziehen Sie die Autonomieentscheidung erst in den Übergang ein, wenn die Kontrollverteilung klar ist. Die relevante Frage ist nicht, ob maximale Geschwindigkeit attraktiv ist, sondern ob die Organisation die größere Fehlerauswirkung bei Edge Cases akzeptiert. Wo dies nicht passt, bleibt Human-in-the-Loop Teil der gewählten parallelen Einrichtung. So bleibt die vorübergehende Einführung auf eine nachweisbare Verteilung von Verarbeitung und Kontrolle ausgerichtet, nicht auf ein abstraktes Streben nach vollständiger Automatisierung.
Quellen zu diesem Abschnitt: Laravel Documentation: Queues and Horizon
Häufig gestellte Fragen zur parallelen Einführung von KI-Prozessen
Die Wahl zwischen einem fertigen KI-Dienst und einer individuellen Einrichtung wird häufig als Wahl zwischen einem schnellen Start und späterer Verfeinerung dargestellt. Für die parallele Verarbeitung ist die Abwägung spezifischer: Entscheidend ist, wie viel Kontrolle über Isolierung, Queues und Rückfallwege während des vorübergehenden Übergangs erforderlich ist.
- „Können wir für den Parallelbetrieb nicht einfach ein fertiges KI-SaaS-Tool verwenden?“
Ein fertiges KI-SaaS-Tool kann einen schnellen ersten Start ermöglichen. Diese Geschwindigkeit sagt jedoch nicht automatisch etwas darüber aus, in welchem Maß die Organisation Parallelbetrieb und Datenisolierung granular steuern kann. Wenn die parallele Phase vor allem dazu dient, den neuen Weg schnell zu erkunden, kann diese anfängliche Zugänglichkeit attraktiv sein. Soll die Phase hingegen als kontrollierter Übergang neben der bestehenden operativen Verarbeitung funktionieren, stellt sich eine andere Frage: Ist die erforderliche Kontrolle über die einzelnen Wege tatsächlich verfügbar? - „Warum erfordert eine individuelle Laravel-Lösung mehr Vorbereitung?“
Eine individuelle Laravel-Architektur erfordert anfängliches Engineering. Dieser Aufwand hängt mit der Einrichtung vollständiger Kontrolle über Queues und Fallbacks zusammen. Für einen Parallelbetrieb ist dies kein Detail, denn Queues bestimmen, wie die Verarbeitung getrennt wird, und Fallbacks bestimmen, was geschieht, wenn der vorgesehene Weg nicht verfolgt werden kann. Die zusätzliche Vorbereitung hängt daher mit dem Maß zusammen, in dem die Organisation diese Übergangsmechanismen selbst steuern möchte, und nicht allein mit der Tatsache, dass KI eingesetzt wird. - „Ist vollständige Kontrolle immer die richtige Wahl?“
Nein. Die Abwägung bleibt von der Rolle des Parallelbetriebs abhängig. Ein schneller Start mit einem SaaS-Tool und eine individuelle Architektur mit vollständiger Kontrolle sind unterschiedliche Positionen, keine automatische Rangfolge. SaaS betont die kurze anfängliche Durchlaufzeit, während eine individuelle Laravel-Lösung die Steuerung von Queues und Fallbacks in den Mittelpunkt stellt. Die Entscheidung wird klarer, wenn Sie festlegen, welche Kontrolle der Übergang benötigt: nur einen ersten Start oder eine Einrichtung, in der parallele Verarbeitung und Datenisolierung präzise gesteuert werden müssen. - „Bedeutet eine individuelle Architektur, dass der alte Weg länger bestehen bleiben muss?“
Die verfügbaren Informationen legen keine feste Dauer fest. Sie zeigen jedoch, dass das anfängliche Engineering bei einer individuellen Lösung mit der Kontrolle über Queues und Fallbacks zusammenhängt. Die Dauer des alten Wegs ergibt sich daher nicht aus der Nutzung von Laravel an sich, sondern aus der gewählten Einrichtung des Parallelbetriebs und dem Maß an Datenisolierung, das während des Übergangs erforderlich ist.
Quellen zu diesem Abschnitt: Continuous Delivery and Operational Release Patterns
Wichtige Überlegungen für eine erfolgreiche parallele Einführung
Die endgültige Entscheidung über eine parallele Einführung erfordert eine formelle Übergangsvereinbarung, die im Voraus festlegt, wann der alte und der neue Weg nebeneinander bestehen bleiben, wann die Einführung fortgesetzt und wann sie gestoppt wird. Dadurch wird aus dem Parallelbetrieb eine kontrollierbare Phase mit nachweisbaren Grenzen statt einer vorübergehenden Sicherheitsmaßnahme.
- Legen Sie Qualitätsgates fest. Ein formeller Übergangsmanagementplan arbeitet mit messbaren Qualitätsgates statt mit subjektiven Bewertungen. Dadurch wird im Voraus klar, zu welchen Zeitpunkten der Fortschritt bewertet wird. Das Gespräch verlagert sich von allgemeinen Eindrücken zu überprüfbaren Ergebnissen, die einen nächsten Schritt rechtfertigen oder nicht.
- Definieren Sie Varianzschwellen. Varianzschwellen geben an, welches Maß an Unterschied innerhalb des parallelen Zeitraums akzeptiert wird. Ohne diese Grenze können Abweichungen bestehen bleiben, ohne dass klar ist, ob sie noch in den Übergang passen. Mit einer festgelegten Schwelle erhält die Organisation eine Grundlage, Unterschiede konsistent zu bewerten, statt jede Abweichung einzeln und nach Ermessen abzuwägen.
- Machen Sie Stop/Go-Kriterien konkret. Konkrete Stop/Go-Kriterien bestimmen nicht nur, wann der neue Weg fortgesetzt werden darf, sondern auch, wann die parallele Phase nicht ausgeweitet wird. Dies verhindert, dass sich der Übergang fortsetzt, weil es keinen formellen Zeitpunkt gibt, an dem eine Entscheidung erzwungen wird. Die Kriterien müssen vor der Bewertung verfügbar sein; nachträglich formulierte Bedingungen machen die Bewertung erneut subjektiv.
- Behandeln Sie den doppelten Aufwand als begrenztes Risiko. Solange alte und neue Prozesse parallel laufen, besteht ein vorübergehender doppelter operativer Mehraufwand. Ohne Stop/Go-Kriterien kann dieser Aufwand andauern, und die finanziellen und operativen Kosten des Übergangs lassen sich schwerer begrenzen. Ein Parallelbetrieb endet daher nicht aufgrund der Gewöhnung an den neuen Weg, sondern auf Grundlage der zuvor festgelegten Qualitätsgates, Varianzschwellen und Stop/Go-Kriterien.
Quellen zu diesem Abschnitt: EU AI Act: Requirements for High-Risk and Operational AI Systems
Dieser Artikel stellt keine Rechtsberatung dar. Die anwendbaren Verpflichtungen hängen vom Zweck, der Funktionalität, dem Nutzungskontext und der Risikoklassifizierung des Systems ab. Lassen Sie die konkrete Anwendung vor dem Produktiveinsatz rechtlich prüfen.
