Voor een snelle, beheerste start met AI-personalisatie kiest u het best één type suggestie op één klantmoment in één kanaal. Kies een context waarin een fout geen directe juridische of onomkeerbare financiële gevolgen heeft, leg vooraf vast welke onzekerheid acceptabel is en zorg voor een vaste standaardervaring wanneer de personalisatie niet kan worden toegepast.
Strategieën voor een gefaseerde AI-personalisatieroadmap
Bij het implementeren van AI-personalisatie is het cruciaal om een roadmap te definiëren die snel zichtbare resultaten oplevert zonder operationele risico's te vergroten. Dit vraagt om een strategische aanpak waarbij een zichtbaar klantmoment niet meteen een brede systeemwijziging vereist.
- Begin met een afgebakende beslissingscontext: één suggestietype, één klantmoment en één kanaal of gebruikersgroep.
- Gebruik een vooraf bepaalde standaardervaring wanneer personalisatie niet bruikbaar of betrouwbaar genoeg is.
- Zorg voor datagereedheid en valideer gegevens voorafgaand aan implementatie.
- Beoordeel de technische haalbaarheid en weeg snelle externe integraties af tegen de beheerbaarheid op langere termijn.
- Bepaal vooraf de acceptabele onzekerheidstolerantie en de gevolgen van fouten.
Hoe een gefaseerde personalisatieroadmap te definiëren
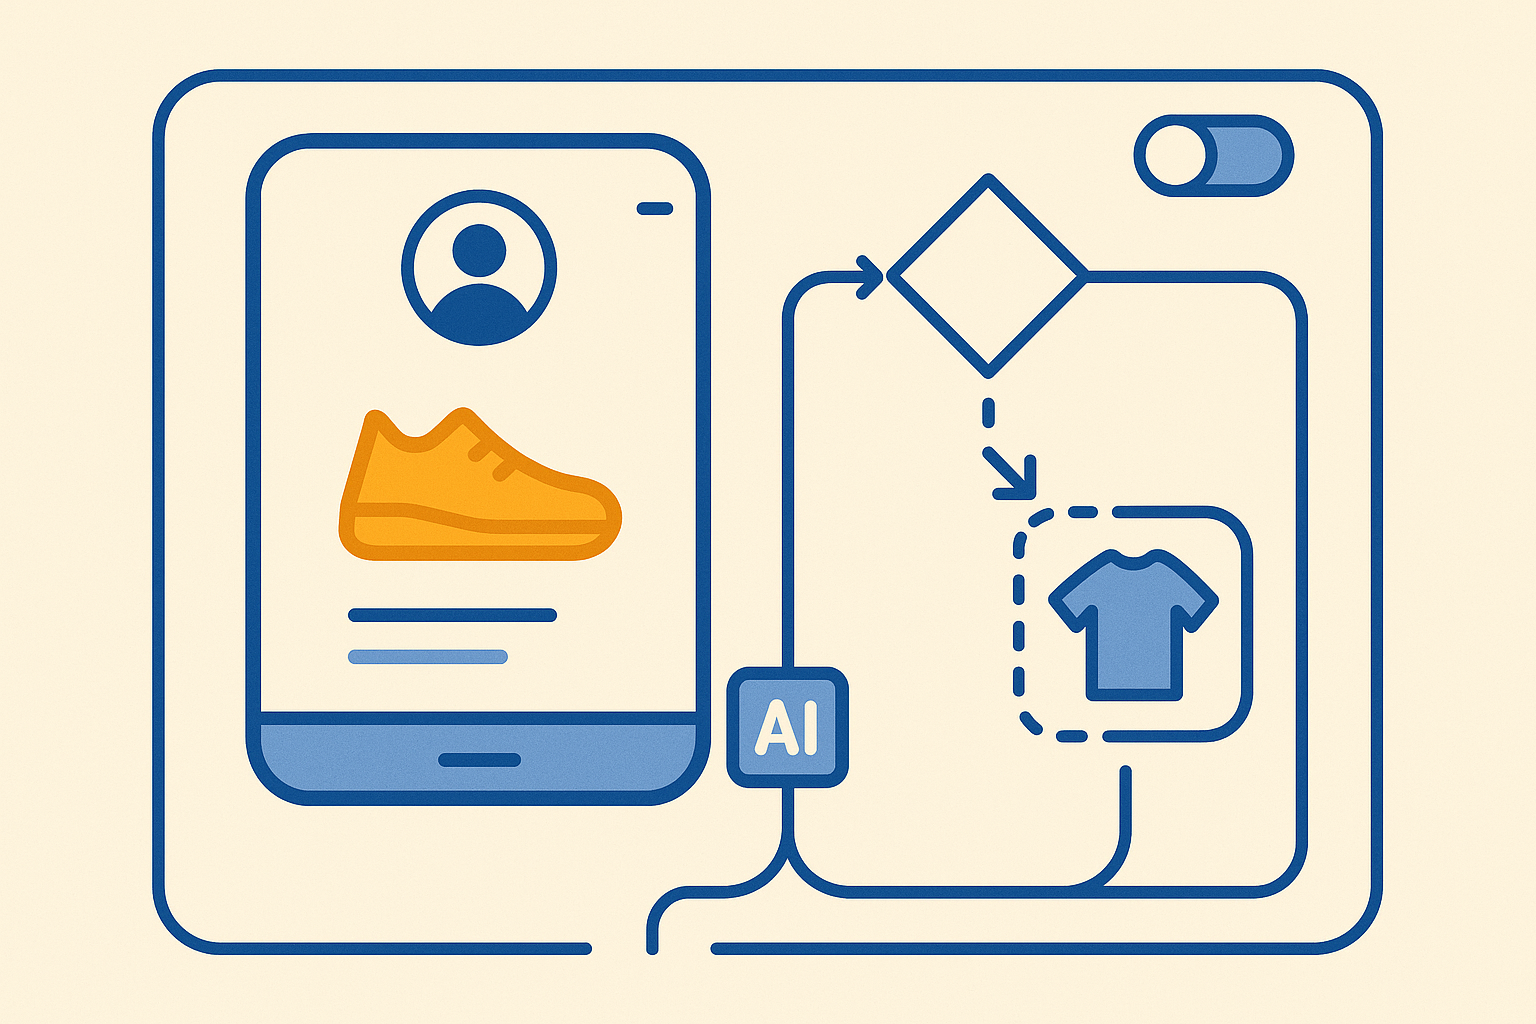
Een gefaseerde personalisatieroadmap begint niet met de vraag welk AI-model het meest kan, maar met de vraag welke beslissing in fase één begrensd genoeg is om zichtbaar te zijn zonder het bedrijfsproces breed te raken. Leiderschap wil vaak binnen het kwartaal een aantoonbaar resultaat zien. Dat resultaat hoeft echter niet voort te komen uit personalisatie op alle kanalen, voor alle klantgroepen of in iedere commerciële stap.
Concreet betekent dit dat fase één één type suggestie, één moment in de klantreis en één beperkte groep gebruikers of één kanaal omvat. De personalisatie blijft dan een voorstel binnen een gecontroleerde context, in plaats van een laag die tal van bestaande processen tegelijk beïnvloedt. Daarmee ontstaat ruimte om de kwaliteit van de uitkomst te beoordelen voordat verdere afhankelijkheden worden toegevoegd. Kies daarbij een besluit waarvan een onjuiste voorspelling geen directe juridische, compliance- of onomkeerbare financiële schade veroorzaakt.
Die grens is meer dan een risicocategorie; zij bepaalt wat een geschikte eerste use case is. Wanneer een personalisatie-uitkomst een beslissing met blijvende gevolgen direct uitvoert, past die minder goed in een snelle eerste fase. Wanneer dezelfde uitkomst alleen een beperkte suggestie oplevert en een veilige standaard beschikbaar blijft, is de foutmarge beter beheersbaar. Leg daarom vooraf vast welke mate van onzekerheid acceptabel is en welke gevolgen buiten die tolerantie vallen. Zo wordt een demonstratie met hoge zichtbaarheid niet ongemerkt een operationele verplichting.
De standaardervaring is daarbij een vast onderdeel van het ontwerp. Als de personalisatie onvoldoende betrouwbaar is, krijgt de klant niet alsnog een willekeurige uitkomst, maar een vooraf bepaalde reguliere suggestie. De klantinteractie blijft beschikbaar, terwijl de AI-uitkomst niet de enige route naar een beslissing vormt.
Voor de verdere fasering past een uitrolwijze waarin modelupdates, datavalidatie en mogelijkheden voor terugdraaien reproduceerbaar worden behandeld. Continuous Delivery for Machine Learning biedt hiervoor principes om wijzigingen geautomatiseerd uit te rollen zonder downtime. Daardoor kan een organisatie na fase één gericht uitbreiden, omdat grenzen, acceptatievoorwaarden en herstelopties al in de roadmap zijn opgenomen.
Bronnen bij deze sectie: martinfowler.com, bhaskarboruah.com
De spanning tussen snelheid en zorgvuldigheid in AI-personalisatie
Een beperkte eerste scope voorkomt niet alleen technische complexiteit; zij maakt ook duidelijk waar gegevensproblemen in de klantinteractie terechtkomen. Ontbrekende velden, dubbele profielen of verouderde transactiehistorie kunnen een suggestie opleveren die niet past bij de actuele klantcontext. Als zulke gegevens direct over meerdere kanalen worden gebruikt, moeten teams achteraf uitkomsten beoordelen, uitzonderingen corrigeren en uitleg geven over interacties die niet aansluiten bij de werkelijke situatie van de klant.
De praktische vraag is daarom niet alleen of data beschikbaar is, maar of die data geschikt is voor precies het gekozen klantmoment. Een gerichte validatie vooraf kan bijvoorbeeld zichtbaar maken welke gegevensbron leidend is, welke gegevens ontbreken en wanneer een profiel niet voldoende basis biedt voor een persoonlijke suggestie. Daardoor wordt snelheid gedefinieerd als een controleerbare lancering met een beperkte leeropgave, niet als het tegelijk koppelen van zoveel mogelijk kanalen en databronnen. Wat in deze fase wordt geleerd over gegevenskwaliteit en uitzonderingen, vormt vervolgens input voor de volgende uitbreiding.
Bronnen bij deze sectie: martinfowler.com
Wanneer is het juiste moment voor AI-personalisatie?
Het juiste moment voor AI-personalisatie wordt niet uitsluitend bepaald door een kwartaaldeadline of de wens om een zichtbare demo te tonen. Het hangt af van de vraag of de eerste toepassing kan werken met een beperkt, beschikbaar en gevalideerd vertrekpunt. Wanneer de organisatie voor een eerste use case gegevens uit meerdere silo’s, meerdere kanalen en uiteenlopende processen moet samenbrengen, verschuift de feitelijke opgave van personalisatie naar een brede integratie-inspanning. Dat kan passend zijn voor een latere fase, maar biedt weinig zekerheid voor een gecontroleerde lancering op korte termijn.
Een geschikter startmoment ontstaat wanneer er één kanaal is waarin historische transactiedata direct beschikbaar en gevalideerd is. Die beperking verkleint de afhankelijkheid van andere gegevensstromen en maakt de vraag concreter: kan deze ene vorm van suggestie onder bekende omstandigheden waardevol en verantwoord worden getoond? Ook de beoordeling van de uitkomsten blijft dichter bij de oorspronkelijke zakelijke doelstelling, omdat minder factoren tegelijk veranderen.
De timing is pas verdedigbaar wanneer er tevens een alternatief bestaat voor situaties waarin de betrouwbaarheid van de personalisatie niet hoog genoeg is. Met confidence thresholds, vooraf ingestelde betrouwbaarheidsgrenzen, kan worden bepaald wanneer de toepassing geen gepersonaliseerde uitkomst toont. Cold-start heuristieken zijn eenvoudige standaardregels voor klanten met te weinig historische gegevens, zoals een voorstel op basis van categorietrends of populariteit. Zo blijft de ervaring bruikbaar zonder te suggereren dat elke aanbeveling even persoonlijk of betrouwbaar is.
Dit maakt een eerste lancering ook passend wanneer het klantenbestand of de beschikbare historische gegevens nog niet overal dezelfde diepgang hebben. In plaats van de uitrol uit te stellen tot iedere klantgroep voldoende gegevens heeft, kan de toepassing beperkt starten waar de voorwaarden wel aanwezig zijn. Voor andere situaties blijft de standaardroute beschikbaar. Die route is geen noodgreep achteraf, maar een vooraf gekozen onderdeel van de klantinteractie.
De praktische timingregel luidt daarmee: start wanneer één kanaal met gevalideerde historische transactiedata beschikbaar is én wanneer de toepassing bij onvoldoende betrouwbaarheid automatisch op een bruikbare standaard kan terugvallen. Ontbreekt één van beide voorwaarden, dan is voorbereiding zinvoller dan een brede eerste uitrol.
Belangrijkste criteria voor AI-personalisatie in fase één
Bij het selecteren van een AI-personalisatie use-case voor fase één helpen vier criteria om onder tijdsdruk een keuze te maken die zichtbaar resultaat oplevert en beheersbaar blijft binnen de bestaande organisatie en infrastructuur.
- Klantimpact en corrigeerbaarheid. Kies een toepassing die voor de klant merkbaar is, maar waarbij een foutieve uitkomst niet direct tot onherstelbare gevolgen leidt. Het gaat om een klantmoment dat zichtbaar is voor leidinggevenden, zonder dat een verkeerde personalisatie direct een proces of klantrelatie schaadt. De mogelijkheid om uitkomsten te corrigeren of te herzien is in deze fase belangrijker dan maximale reikwijdte.
- Technische haalbaarheid versus demonstratiesnelheid. Een snelle demo via externe cloud-API’s kan geschikt zijn wanneer snelheid, beperkte integratie en een tijdelijke of duidelijk afgebakende toepassing vooropstaan. Maatwerkintegraties binnen de eigen backend kunnen meer controle bieden wanneer beheer, gegevensverwerking en toekomstige uitbreiding zwaarder wegen. De kosten en afhankelijkheden verschillen per volume, contract en onderhoudslast; beoordeel daarom beide routes op de gekozen scope, niet alleen op de snelheid van de eerste demo.
- Integratie-inspanning als afbakening. Breng scherp in kaart welke koppelingen echt noodzakelijk zijn voor het gekozen klantmoment. Hoe meer systemen direct betrokken moeten worden, hoe groter de kans op vertraging door afhankelijkheden buiten de eigen scope. Een beperkte integratie in fase één maakt de uitrol beheersbaarder en voorkomt dat proceswijzigingen te veel tegelijk moeten worden afgestemd.
- Organisatorische gereedheid en dataverantwoording. Zorg dat helder is waar gebruikersdata wordt verwerkt en hoe deze traceerbaar door het systeem loopt. Transparantie over datalocatie en data-lineage ondersteunt de beoordeling van verplichtingen rond gegevensverwerking, waaronder de AVG/GDPR, en helpt interne besluitvorming te onderbouwen. Onvoldoende duidelijkheid hierover kan ertoe leiden dat een technisch werkende oplossing alsnog vastloopt op vragen over gebruik en verantwoording van data.
Bronnen bij deze sectie: martinfowler.com
Een gestructureerd kader voor AI-personalisatiebeslissingen

Gebruik dit kader om een personalisatiebeslissing zo in te richten dat een waarschijnlijkheidsuitkomst niet zonder controle verandert in een klantactie. Het kader scheidt suggestie, beoordeling en uitvoering.
- 1. Behandel de modeluitkomst als een voorstel, niet als de actie zelf. Een personalisatie-uitkomst is probabilistisch: zij geeft een inschatting, geen vaststaand feit. Plaats daarom een duidelijke grens tussen de output en wat de klant uiteindelijk ziet of ontvangt. API-isolatielagen zijn tussenschakels die de modeluitkomst gescheiden houden van de uitvoerende toepassing. Daardoor ontstaat een afzonderlijk punt waarop de organisatie kan bepalen of een voorstel binnen de afgesproken context gebruikt mag worden.
- 2. Leg validatielogica vast in de webapplicatie. De applicatielaag is de plaats waar regels worden toegepast voordat een voorstel tot klantactie leidt. In Laravel-servicelagen kan validatielogica voorkomen dat ongeldige gegevens of prijsafwijkingen worden doorgegeven. De personalisatie krijgt zo niet de ruimte om buiten de overeengekomen zakelijke grenzen te handelen. Het gaat niet om het verfijnen van het model zelf, maar om de vraag welke uitkomsten überhaupt mogen doorwerken in de klantreis.
- 3. Koppel elke validatie-uitkomst aan een vaste standaardroute. Wanneer de validatie een voorstel blokkeert, moet de klantinteractie niet onduidelijk worden of stilvallen. Leg daarom vooraf vast welke reguliere suggestie of handeling dan volgt. De organisatie kan die route beoordelen op klantvriendelijkheid en operationele gevolgen, ook wanneer prijs, gegevenskwaliteit of andere zakelijke voorwaarden een gepersonaliseerd voorstel uitsluiten.
- 4. Maak wijzigingen toetsbaar vóór zij breed effect hebben. Continuous Delivery for Machine Learning koppelt de uitrol van personalisatie aan geautomatiseerde regressietests, modelversiebeheer en voortdurende monitoring op data drift. Regressietests ondersteunen de controle dat eerder werkende onderdelen bij een wijziging blijven functioneren. Versiebeheer maakt herleidbaar welke modelvariant actief is. Monitoring op data drift houdt zicht op veranderingen in de gegevens waarmee de personalisatie werkt.
- 5. Beoordeel uitbreiding aan de hand van de afgesproken grens. Breid pas uit wanneer de scheiding tussen voorstel en uitvoering overeind blijft, validatieregels ongewenste uitkomsten tegenhouden en de standaardroute bruikbaar is. Zo wordt groei een besluit op basis van aantoonbare controle, in plaats van een automatisch vervolg op een werkende demo.
Bronnen bij deze sectie: martinfowler.com
Veelgestelde vragen over AI-personalisatie in fase één
De volgende vragen gaan over een terugkerend bezwaar bij een eerste personalisatiefase: levert een begrensde aanpak wel voldoende resultaat op, of blijft de organisatie hangen in een tijdelijke oplossing?
- “Is een hybride aanpak niet te beperkt om echt resultaat te laten zien?”
Een hybride scoringmodel combineert personalisatie met vaste zakelijke regels. Dat beperkt de mate waarin de toepassing volledig autonoom en dynamisch reageert, maar maakt de grenzen wel voorspelbaar. Voor een eerste uitrol kan dit juist bruikbaar zijn: de organisatie toont een persoonlijke ervaring waar de uitkomst passend is, zonder iedere klantinteractie afhankelijk te maken van een autonome beslissing. - “Waarom niet direct kiezen voor volledig autonome, dynamische personalisatie?”
Volledige autonomie kan aantrekkelijk lijken wanneer leiderschap snelheid en vernieuwing verwacht. Daartegenover staat een hoger afbreukrisico: een ongeschikte uitkomst bereikt de klant zonder dat vooraf vastgelegde regels de actie eerst begrenzen. De keuze is daarom niet tussen vooruitgang en stilstand, maar tussen brede autonomie met meer onzekerheid en een gecontroleerde toepassing die later kan worden uitgebreid. - “Worden vangrails een permanente rem op verdere ontwikkeling?”
Niet wanneer zij worden behandeld als expliciete voorwaarden voor klantacties. Vaste regels maken zichtbaar welke uitkomsten de organisatie wel en niet wil doorlaten. Dat biedt een basis om latere uitbreiding gericht te beoordelen: een nieuwe toepassing krijgt pas meer ruimte wanneer duidelijk is welke regels nog gelden en welke grenzen verantwoord kunnen veranderen. - “Is een standaardroute voor klanten zonder passende personalisatie een teken dat de oplossing tekortschiet?”
Nee. In een eerste fase voorkomt die route dat de toepassing een persoonlijke suggestie simuleert wanneer de onderliggende score daarvoor onvoldoende basis biedt. De klant ontvangt nog steeds een voorspelbare interactie. Daarmee wordt het streven naar een persoonlijker aanbod niet afhankelijk van een uitkomst die willekeurig of niet passend kan overkomen. - “Welke concessie maken we feitelijk in fase één?”
De organisatie kiest niet onmiddellijk voor de meest autonome vorm van personalisatie. Daar staat een eerste toepassing tegenover waarin de grenzen van klantacties vooraf bekend zijn. De afweging draait dus om tempo met controle versus radicale vernieuwing met een groter afbreukrisico.
Belangrijke overwegingen voor AI-personalisatie in fase één
Een eerste uitrol is sterker wanneer niet alleen duidelijk is wat wordt getoond, maar ook hoe een ongewenste uitkomst direct uit de klantreis verdwijnt. De onderstaande overwegingen maken terugdraaibaarheid concreet.
- Maak de uitrol afzonderlijk schakelbaar. Feature toggles maken het mogelijk om personalisatie per kanaal of gebruikersgroep te activeren en te deactiveren. Daardoor hoeft een verandering niet overal tegelijk zichtbaar te zijn. Een organisatie kan de toepassing beperken tot de groep of het kanaal waarvoor de eerste fase is bedoeld, terwijl andere klantinteracties ongewijzigd blijven.
- Behandel rollback als onderdeel van de commerciële inzetbaarheid. Een expliciete rollback-architectuur biedt de mogelijkheid om personalisaties direct en zonder downtime te deactiveren. Dat is niet alleen relevant voor het beheer van de toepassing. Wanneer een personalisatie niet aansluit bij de klantcontext, kan voortzetting leiden tot herstelwerk in commerciële en operationele processen. De mogelijkheid om terug te schakelen beperkt de periode waarin een ongewenste uitkomst zichtbaar blijft.
- Leg vooraf vast wie de schakelbeslissing neemt. Een feature toggle heeft alleen waarde als helder is onder welke omstandigheden deze wordt gebruikt. De verantwoordelijke moet kunnen vaststellen of een afwijking binnen de acceptabele grens valt of aanleiding geeft om de personalisatie voor een kanaal of gebruikersgroep uit te zetten. Dit voorkomt dat de technische mogelijkheid tot terugdraaien bestaat, maar de besluitvorming erover pas tijdens een incident begint.
- Gebruik kanaal- en groepsgerichte controle als brug naar volgende fasen. Het apart kunnen activeren en deactiveren van personalisatie maakt uitbreiding minder alles-of-niets. De organisatie kan verschillen tussen kanalen of gebruikersgroepen afzonderlijk beoordelen en voor ieder nieuw bereik een eigen hersteloptie behouden. Daarmee blijft de impact van een klantfout beperkt, ook terwijl de roadmap verder groeit.
Bronnen bij deze sectie: martinfowler.com
Dit artikel biedt geen juridisch advies. De toepasselijke verplichtingen hangen af van het doel, de functionaliteit, de gebruikerscontext en de risicoclassificatie van het systeem. Laat de concrete toepassing juridisch beoordelen vóór productiegebruik.