Een onderhoudsretainer voor Laravel-applicaties biedt ondersteuning op basis van afzonderlijke verzoeken. Een operationeel model voor managed support richt zich op de blijvende werking van de applicatie, met planning, versiebeheer en expliciete governance. Het verschil zit dus niet alleen in beschikbare uren, maar vooral in de manier waarop terugkerende risico’s en onderhoudswerk worden georganiseerd.
Kiezen tussen onderhoudsretainer en managed support voor Laravel
De keuze draait om de verdeling van eigenaarschap, de benodigde interne capaciteit en de gewenste voorspelbaarheid van wijzigingen.
- Een onderhoudsretainer past bij incidentele wijzigingen en organisaties die zelf prioriteiten, risico’s en releases kunnen aansturen.
- Managed support reserveert aandacht voor gepland onderhoud, versiebeheer en structurele opvolging.
- Ad-hoc support kan interne IT-teams belasten met coördinatie, prioritering en escalaties.
- Interne regie vraagt om voldoende technische capaciteit; managed support kan operationele taken binnen een afgesproken scope overnemen.
- Gecontroleerde releaseprocessen vergroten de voorspelbaarheid, maar laten minder ruimte voor directe ad-hocaanpassingen.
Wat onderscheidt een onderhoudsretainer van een operationeel model voor Laravel?
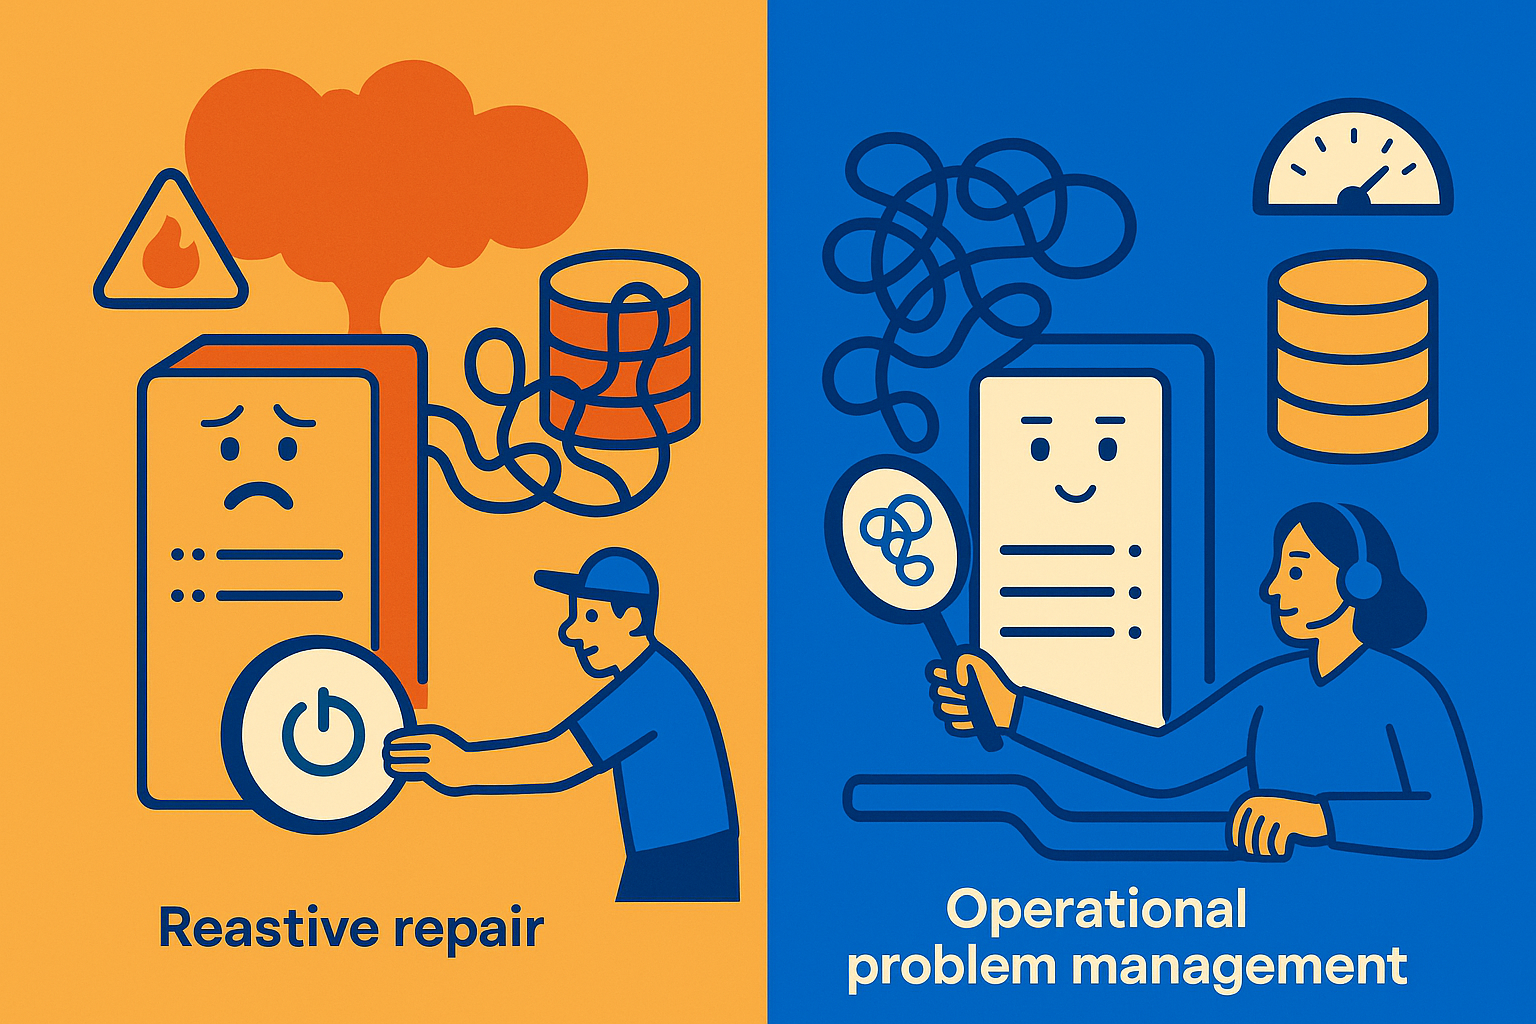
Een onderhoudsretainer voor een Laravel-applicatie is in de kern een afspraak over beschikbare capaciteit. De organisatie meldt een fout, een gewenste update of een storing, waarna de leverancier uren inzet om die concrete taak af te handelen. Dat model kan passend zijn wanneer de applicatie overzichtelijk is, de interne organisatie zelf de prioriteiten, risico’s en releasebesluiten beheerst, en ondersteuning vooral incidenteel nodig is. De leverancier werkt dan primair op opdracht: zonder ticket is er doorgaans geen aanleiding om structureel in te grijpen.
Een operationeel model voor managed application support verschuift het uitgangspunt naar de blijvende werking van de applicatie. Daarbij hoort een onderscheid tussen incidentbeheer en structureel probleembeheer. Een incident vraagt om herstel van de dienstverlening; probleembeheer onderzoekt waarom het incident kon ontstaan en welke onderliggende oorzaak herhaling mogelijk maakt. Een root cause analysis (RCA) kan daarbij helpen om terugkerende storingen niet alleen te herstellen, maar ook als verbeterwerk te plannen.
Operationeel eigenaarschap betekent niet dat de organisatie haar zakelijke verantwoordelijkheid overdraagt. Functionele keuzes, prioriteiten en risicoacceptatie blijven besluitpunten voor de organisatie. Wel worden verantwoordelijkheden rond de technische werking expliciet belegd en bestuurbaar gemaakt. Governance maakt zichtbaar wie een escalatie oppakt, wie wijzigingen beoordeelt en hoe de voortgang van structurele acties wordt gevolgd. Daarmee ontstaat een vast ritme voor het beheren van afhankelijkheden en het afwegen van herstelwerk tegen verbeterwerk.
Het onderscheid wordt duidelijk in een hypothetisch voorbeeld. Stel dat een Laravel-worker uitvalt door een geheugenlek. Een reactieve inzet kan bestaan uit het herstarten van de worker en het verhogen van de beschikbare geheugenlimiet binnen het ticketbudget. Als een ongeoptimaliseerde query de werkelijke oorzaak blijft, kan de belasting bij datagroei oplopen totdat databaseverbindingen tijdens een piek uitgeput raken. De eerste melding is dan gesloten, maar de aanleiding voor een bredere verstoring is niet weggenomen. Een operationeel model biedt ruimte om de oorzaak te onderzoeken en dit structurele werk in te plannen.
Dit verschil werkt door in de interne IT-organisatie. Bij ad-hoc support blijven coördinatie, prioritering en crisisescalaties gemakkelijk bij het interne team liggen. Die belasting kan tijd onttrekken aan digitaliseringsprojecten en maakt de continuïteit afhankelijk van individuele beschikbaarheid. De keuze gaat daarom niet alleen over het aantal ontwikkeluren, maar ook over de vraag wie de operationele samenhang bewaakt.
Bronnen bij deze sectie: itsm.tools, atlassian.com
Waarom is de keuze tussen onderhoud en managed support belangrijk?
Voor organisaties met beperkte interne IT-capaciteit beïnvloedt de keuze direct de continuïteit en het beheersen van risico’s. In een puur reactieve onderhoudsafspraak wacht de leverancier op tickets en krijgen updates vaak pas aandacht bij een urgente melding. Zonder vaste lifecycleplanning kunnen Laravel-, PHP- en dependency-updates daardoor langer blijven liggen dan gewenst. Wanneer een upgrade later alsnog onder tijdsdruk moet gebeuren, neemt de kans toe dat productie-integraties en interne planning worden verstoord.
Ook het ontbreken van releaseplanning kan gevolgen hebben. Als onderhoudswerk steeds wordt gecombineerd met functionele wijzigingen, kunnen beveiligingspatches of noodzakelijke dependency-updates vertraging oplopen. Onverwachte rollbacks en spoedinterventies kunnen de aanvankelijke eenvoud van een reactief model vervolgens onder druk zetten. Dit speelt vooral wanneer niemand intern de samenhang tussen updates, releases en incidenten structureel bewaakt.
Een managed supportmodel legt juist een werkproces vast voor structurele planning, versiebeheer en regie over onderhoudswerk. In plaats van upgrades pas na een incident te beoordelen, worden relevante wijzigingen periodiek beoordeeld en ingepland op basis van de applicatiesituatie en beschikbare test- en acceptatieruimte. Voor organisaties zonder eigen ontwikkelteam maakt dat onderhoud beter voorspelbaar, omdat het niet volledig afhankelijk is van incidentele capaciteit.
Bronnen bij deze sectie: securinglaravel.com, atlassian.com, nist.gov, iflair.com
Wanneer is een vergelijking tussen onderhoud en managed support relevant?

Een vergelijking tussen basisonderhoud en een gestructureerd managed supportmodel wordt relevant zodra de operationele eisen verder gaan dan het oplossen van afzonderlijke incidenten. Bij uitsluitend correctief onderhoud kunnen patronen buiten beeld blijven: dezelfde fout wordt hersteld, terwijl de interne IT-manager moet signaleren dat meldingen terugkeren. Dat is een aanwijzing dat niet alleen herstelcapaciteit, maar ook analyse en opvolging nodig zijn.
De behoefte aan een gestructureerd model wordt duidelijk wanneer het werk zich uitbreidt naar adaptief onderhoud, zoals dependency- en PHP-upgrades, preventief onderhoud, zoals security scans en codekwaliteit, en perfectief onderhoud, zoals prestatieverbeteringen en refactoring. Deze werkzaamheden concurreren gemakkelijk met urgente tickets en nieuwe functionaliteit. Een vaste beheerscope maakt zichtbaar welk werk wordt gepland, welke risico’s wachten en wie daarover een besluit neemt.
Hetzelfde geldt wanneer wijzigingen niet meer vrijblijvend mogen plaatsvinden. Geautomatiseerde release-validaties en duidelijke wijzigingsprocessen kunnen de voorspelbaarheid verhogen, maar vragen om vooraf bepaalde bevoegdheden en acceptatiemomenten. Dan gaat de afweging minder over het label van de dienstverlening en meer over de vraag of het interne team deze beheerdiscipline zelf duurzaam kan dragen.
Bronnen bij deze sectie: iteh.ai, itsm.tools, atlassian.com
Vergelijking van onderhoudsretainers en managed supportmodellen
De benamingen van diensten verschillen per leverancier. Daarom geeft de onderstaande vergelijking geen vaste productdefinitie, maar concrete punten waarop u scope, eigenaarschap en governance kunt toetsen. Een retainer kan aanvullende afspraken bevatten; managed support is pas herkenbaar wanneer de operationele onderdelen ook expliciet zijn belegd.
| Aspect | Onderhoudsretainer | Managed supportmodel | Waarop toetsen |
|---|---|---|---|
| Aansturing van werkzaamheden | Werk start doorgaans vanuit een afzonderlijk verzoek of ticket. De opdrachtgever bepaalt per onderwerp of uren worden ingezet. | De applicatie wordt volgens een vaste beheerscope gevolgd, naast de afhandeling van meldingen. | Vraag welke werkzaamheden ook zonder nieuw ticket worden ingepland en wie daarop stuurt. |
| Eigenaarschap | De interne organisatie houdt in de praktijk veel regie over prioriteiten, opvolging en escalatie. | Technisch platformeigenaarschap, functioneel beheer en compliance zijn expliciet verdeeld. | Leg de verdeling vast in een RACI-matrix, zodat per activiteit duidelijk is wie uitvoert, beslist, wordt geraadpleegd en wordt geïnformeerd. |
| Governance | Overleg kan naar behoefte plaatsvinden en concentreert zich vaak op openstaand werk. | Periodieke service reviews, formele escalatielijnen en heldere verantwoordelijkheden vormen een vast onderdeel van de dienstverlening. | Beoordeel of reviews leiden tot besluiten, opvolging en een gedeeld beeld van open risico’s. |
| Versie- en afhankelijkheidsbewaking | Updates krijgen aandacht wanneer zij worden aangevraagd of wanneer een incident dat afdwingt. | Laravel-, PHP- en Composer-dependencies worden periodiek beoordeeld en in samenhang ingepland. | Vraag hoe de partner relevante ondersteuningsinformatie volgt en voorkomt dat noodzakelijke updates onnodig blijven wachten. |
| Releasebesluitvorming | Functionele wensen, dependencies en beveiligingswerk kunnen in één werkstroom terechtkomen. | Wijzigingen worden gescheiden beoordeeld en gecontroleerd ingepland. | Onderzoek of noodzakelijke dependency- en beveiligingsupdates onafhankelijk van openstaande functionele wensen kunnen doorlopen. |
| Risico bij vertraging | Wanneer updates vastlopen in acceptatie door andere wijzigingen, kan blootstelling aan beveiligingsrisico’s voortduren. | Releasegovernance maakt zichtbaar welke wijziging wacht, waarom zij wacht en wie een besluit neemt. | Vraag niet alleen naar responstijd, maar ook naar het proces voor blokkades, escalatie en vrijgave. |
Bronnen bij deze sectie: securinglaravel.com, itsm.tools, atlassian.com, nist.gov, iflair.com
Wat zijn de afwegingen tussen onderhoud en managed support?
De modellen verdelen eigenaarschap, controle en risico’s anders. De belangrijkste afwegingen zitten niet alleen in snelheid, maar ook in de kwaliteit van het wijzigingsproces en de zichtbaarheid van uitgevoerd beheer.
- Directe wijzigingsvrijheid versus gecontroleerde releases. Een onderhoudsretainer maakt het eenvoudig om wijzigingen als losse opdrachten uit te voeren. Zonder een vaste validatieroute is het echter minder vanzelfsprekend dat onderhoudswijzigingen grondig worden getest voordat ze in productie gaan. In een managed supportmodel kunnen CI/CD-testpijplijnen, staging-validatie en rollback-procedures onderdeel zijn van de beheerafspraken. Dat helpt om de impact op kritische koppelingen, zoals ERP- of CRM-systemen, vooraf te beoordelen. De keerzijde is dat wijzigingen een vastgesteld proces doorlopen en daardoor niet altijd direct kunnen worden uitgevoerd.
- Uitbesteding van beheer versus transparantie. Managed support kan operationele taken overnemen, maar de organisatie behoudt bestuurlijke verantwoordelijkheid. Wanneer een leverancier brede ontzorging belooft zonder inzicht in patchniveaus, beschikbaarheid of geteste back-upherstel, ontstaat een zwarte doos. Transparante rapportage maakt daarom zichtbaar welke activiteiten zijn uitgevoerd, welke risico’s openstaan en welke beslissingen nog nodig zijn. Bij een retainer ligt die administratie vaker intern; bij managed support verschuift de uitvoering naar de partner, maar niet de noodzaak van inzicht en toezicht.
Bronnen bij deze sectie: atlassian.com
Veelgestelde vragen over Laravel onderhoud en managed support
De volgende vragen gaan over de verdeling van regie en capaciteit, niet over een technische vergelijking van frameworks. De antwoorden helpen om contracttaal te vertalen naar de praktische werking van het supportmodel.
- Verlies ik bij managed support alle regie over de Laravel-applicatie?
Niet noodzakelijk. Het verschil zit in welke operationele beslisbevoegdheid en patchautorisatie aan de partner wordt gedelegeerd. Als de organisatie volledige interne regie over urenbesteding behoudt, vraagt dat ook aanzienlijke technische capaciteit voor backlogbeheer. Iemand moet dan beoordelen welk onderhoud voorrang krijgt, welke wijziging wordt geautoriseerd en welke gevolgen vertraging heeft. In een managed model kan de partner binnen een afgesproken scope operationele beslissingen en patchautorisaties uitvoeren. Dat vervangt bestuurlijke keuzes van de organisatie niet, maar vermindert de noodzaak om iedere technische stap afzonderlijk intern te organiseren. Een bruikbare afspraak maakt expliciet welke besluiten de partner zelfstandig neemt, welke voorafgaande goedkeuring vragen en hoe afwijkingen worden geëscaleerd. - Kunnen we alle beschikbare capaciteit op nieuwe functies richten en onderhoud later plannen?
Dat kan op korte termijn aantrekkelijk lijken, maar featureontwikkeling verdringt stabiliteitswerk wanneer capaciteit niet structureel is gereserveerd voor preventief onderhoud, refactoring en dependency-upgrades. De vraag is daarom of beide typen werk een expliciete plek in de planning krijgen. Een retainer kan dit bieden wanneer de organisatie die reservering consequent zelf bewaakt. In een managed model kan dit onderdeel zijn van de operationele scope, mits daar ook ruimte is voor preventief en verbeterend werk.
Bronnen bij deze sectie: iteh.ai, atlassian.com
Belangrijke overwegingen bij het kiezen van een supportmodel voor Laravel
Een bruikbare selectie begint met bewijs van de manier waarop beheer wordt uitgevoerd, niet met de naam van het pakket. De onderstaande criteria maken onderscheid tussen beschikbare ontwikkelcapaciteit en een beheerd operationeel model controleerbaar. Zij verbinden technische beheersing met de vraag welke financiële en operationele risico’s de organisatie nog zelf draagt.
- Controleer de releaseketen in plaats van alleen de belofte van onderhoud. Vraag of er geautomatiseerde CI/CD-testsuites zijn ingericht, bijvoorbeeld met Pest of PHPUnit, en hoe een stagingomgeving wordt gebruikt voordat een wijziging wordt uitgerold. Laat ook toelichten hoe deployment- en rollbackprocedures zijn vastgelegd. Het doel is niet om een bepaalde tool voor te schrijven, maar om vast te stellen of een partner een reproduceerbare route heeft van wijziging naar productie en terug. Zonder die route blijft onduidelijk hoe een fout in een release wordt opgevangen.
- Maak rapportage en verbetering toetsbaar. Servicerapportage kan inzicht geven in applicatieprestaties, responstijden, de stabiliteit van queues en openstaande technical-debtpunten. Belangrijker is wat daarna gebeurt: vraag of terugkerende incidenten een RCA krijgen, hoe verbeteracties worden gevolgd en met welke vaste reviewcadans de voortgang wordt besproken. Zo krijgt continual service improvement (CSI) een praktische invulling: niet als losse belofte, maar als een herhaalbaar proces van signaleren, besluiten en opvolgen. Een supportmodel is bestuurbaar wanneer gegevens, besluiten en verantwoordelijkheden op elkaar aansluiten.