
Om te valideren dat een security-sensitive API-integratie kritieke operaties kan blijven uitvoeren onder storingen, uitval en herstelscenario's vóór go-live, moet een formeel continuïteitstestplan worden geïmplementeerd. Dit plan omvat gecontroleerde storingsinjectie, het gebruik van het Transactional Outbox-patroon, idempotente verwerking, fail-fast circuit breakers, en begrensde retries met exponentiële backoff. Deze maatregelen helpen de integratie operationeel, betrouwbaar en beheerst te houden wanneer de normale ketenverwerking afwijkt.
Validatie van API-integraties voor continuïteit
Het artikel behandelt de noodzaak van een pre-go-live continuïteitstestplan voor security-sensitive API-integraties. Met security-sensitive worden hier integraties bedoeld die bijvoorbeeld financiële mutaties, persoonsgegevens, toegangsbeslissingen of andere bedrijfscritische gegevens verwerken, waarbij een fout meer gevolgen heeft dan alleen tijdelijke onbeschikbaarheid. Het richt zich op het valideren van de operationele robuustheid van deze integraties onder verschillende storingsscenario's.
- Identificeer en valideer faalpaden via gecontroleerde storingsinjectie, zoals timeouts en rate limits.
- Gebruik het Transactional Outbox-patroon om data-integriteit te waarborgen en dubbele transacties te voorkomen.
- Implementeer circuit breakers en begrensde retries om kettingreacties en resource-uitputting te voorkomen.
- Koppel go-live beslissingen aan objectieve acceptatiecriteria en een gevalideerd rollback-runbook.
Belang van continuïteitsvalidatie voor API-integraties
Een API-integratie is pas operationeel beoordeeld wanneer duidelijk is wat er gebeurt als een afhankelijk systeem niet reageert, een antwoord te laat komt of een mutatie wel is uitgevoerd maar de bevestiging verloren gaat. In een security-sensitive proces gaat het dan niet alleen om bereikbaarheid. De kernvraag is of de bedrijfswerking en de gegevensstaat beheerst blijven wanneer de keten afwijkt van het normale verloop. Continuïteitsvalidatie maakt die vraag toetsbaar voordat gebruikers en kritieke processen van de koppeling afhankelijk worden.
Een veelvoorkomend risicopad ontstaat bij een betalings- of ordermutatie. Het doelsysteem kan de wijziging al hebben vastgelegd, terwijl de HTTP-respons naar de integratielaag time-out. Als de aanroep daarna zonder een strikte idempotentiesleutel opnieuw wordt aangeboden, verwerkt het doelsysteem dezelfde mutatie mogelijk nogmaals. Financiële saldi en voorraadstanden kunnen dan afwijken, waarna handmatige reconciliatie nodig wordt. Een geslaagde demonstratie ziet dit niet, omdat daarin de respons normaal gesproken tijdig terugkeert en de eerste verwerking zichtbaar slaagt. De feitelijke onzekerheid zit juist in de combinatie van een uitgevoerde actie en een ontbrekend antwoord.
Ook aanhoudende storingen vragen om ander gedrag dan alleen opnieuw proberen. Een Circuit Breaker kan bij opeenvolgende downstream time-outs of 5xx-fouten van Closed naar Open schakelen. Nieuwe verzoeken falen dan direct lokaal, in plaats van dat zij blijven wachten op een systeem dat niet beschikbaar is. Daarmee worden server-threads en databaseverbindingen niet uitgeput door een externe afhankelijkheid. De continuïteit van andere processen wordt zo een afzonderlijk toetsingspunt: het falen van één koppeling mag niet zonder meer interne applicatieroutes onbereikbaar maken.
De benodigde validatie is afhankelijk van de omgeving. Bij een verouderd on-premise doelsysteem zonder ondersteuning voor RFC-standaarden of expliciete rate-limiting ligt een deel van de bescherming bij de maatwerk-integratielaag. Die laag moet dan zelf rate-limiting en state-tracking afdwingen, zodat het bronsysteem niet door aanroepdruk wordt overbelast. Voor go-live is dus bewijs nodig dat deze bescherming ook onder afwijkende omstandigheden werkt, niet enkel dat gegevens op een rustig moment correct worden uitgewisseld.
Waarom een demo niet genoeg is voor go-live
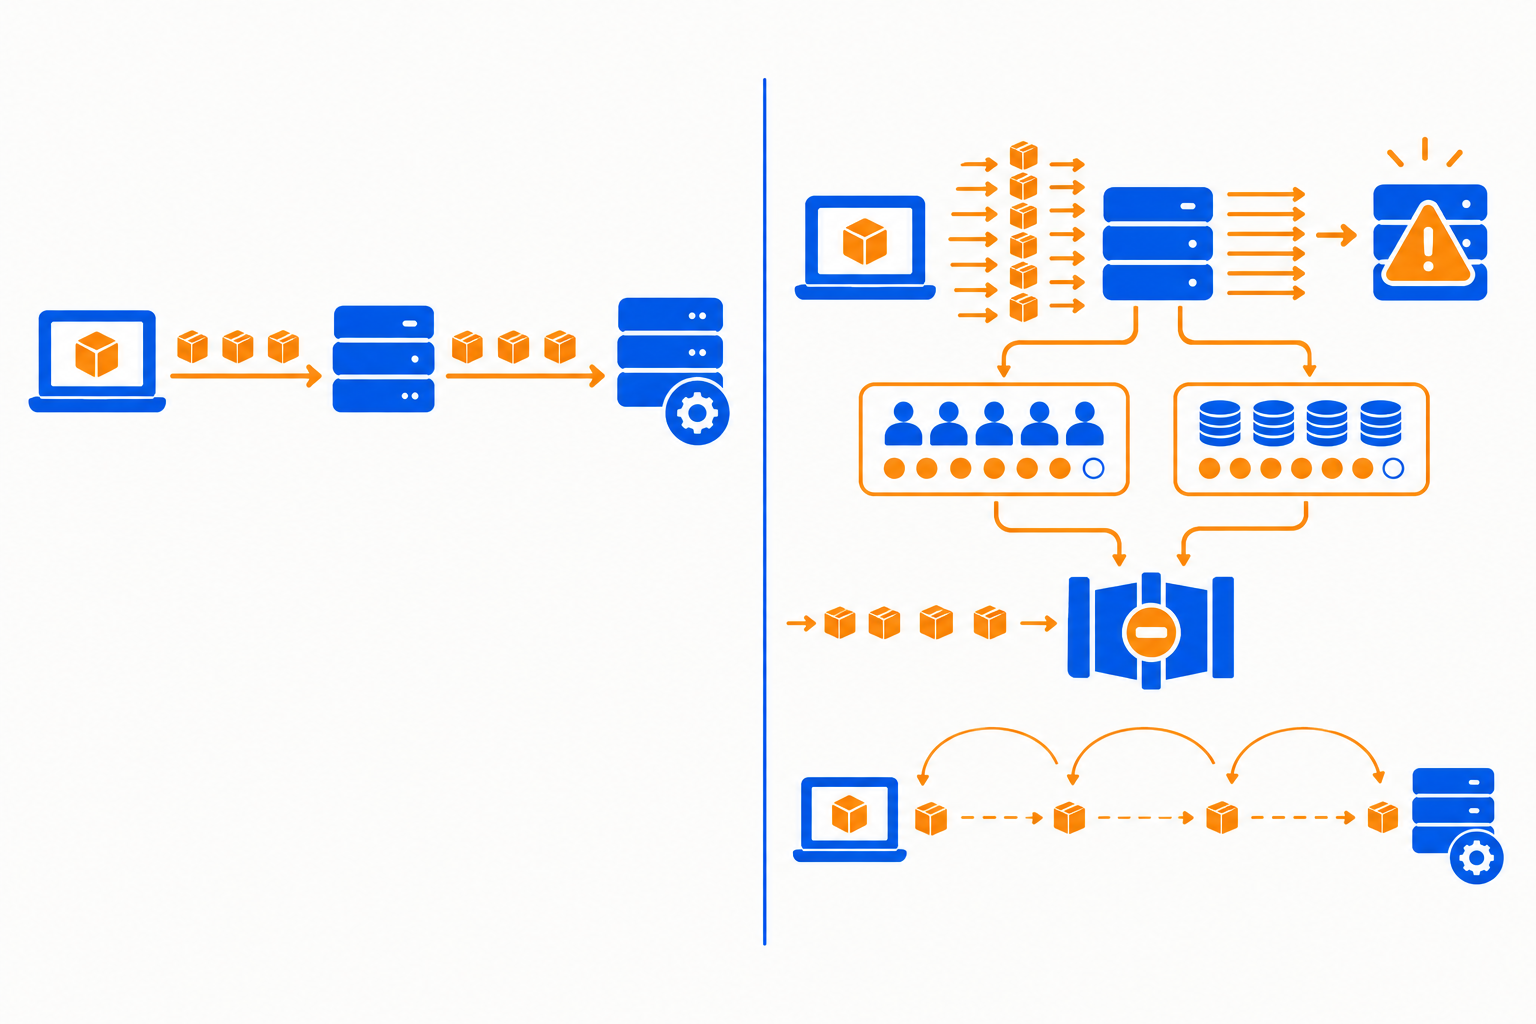
Een demo van een API-integratie toont doorgaans alleen het ideale scenario: een vooraf geselecteerde mutatie loopt via beschikbare endpoints en levert het verwachte resultaat op. Dit bevestigt de functionele werking, maar laat onbelicht hoe de integratie zich gedraagt wanneer externe afhankelijkheden traag reageren, tijdelijk niet beschikbaar zijn of limieten opleggen. In een demo zijn alle endpoints volledig beschikbaar, waardoor niet zichtbaar wordt wat er gebeurt bij HTTP 429- of 503-fouten, of bij netwerk-timeouts. Juist deze afwijkingen zijn bepalend voor de operationele robuustheid van het proces.
In productieomgevingen ontstaan risico’s die in een demo niet aan het licht komen. Als een gekoppeld ERP-systeem onder piekbelasting bijvoorbeeld trage databasevergrendelingen vertoont, kunnen uitgaande HTTP-aanroepen blokkeren. Dat leidt niet alleen tot vertraging in de koppeling zelf, maar kan – afhankelijk van de architectuur en het resourcebeheer – ook interne applicatieroutes onbereikbaar maken doordat werkers en verbindingen uitgeput raken. Een functionele test die alleen controleert of een order wordt doorgestuurd, signaleert deze kettingreactie niet. De relevante vraag is hier of vertraagde afhankelijkheden binnen beheersbare grenzen blijven en of andere processen beschikbaar blijven.
Herstelgedrag vormt een tweede blinde vlek. Bij een tijdelijke netwerkonderbreking kunnen actieve API-koppelingen time-outs veroorzaken. Als de integratielaag vervolgens synchrone retries uitvoert zonder begrenzing of backoff, ontstaat het risico dat bij herstel honderden processen gelijktijdig nieuwe verzoeken sturen. Dit kan de externe API overbelasten en de storing verlengen. Een demo toont alleen het succespad, niet de cumulatieve aanvraagdruk of het effect van massale retries na een storing.
Functionele tests en demo’s zijn dus onvoldoende om operationele robuustheid te bewijzen. Zonder gesimuleerde storingen, gecontroleerde time-outs en hersteltests blijft onduidelijk of de integratie gecontroleerd degradeert, kettingreacties voorkomt en herstel niet tot nieuwe uitval leidt. De waarde van de test zit daarmee in het zicht op het gedrag buiten het normale pad.
Wanneer is continuïteitsvalidatie vereist?
Continuïteitsvalidatie hoort op de agenda zodra een API-integratie een bedrijfsproces muteert, gegevens tussen systemen overdraagt of herstelacties moet uitvoeren na een onzekere verwerking. Het risico is dan niet beperkt tot een tijdelijk ontbrekend schermresultaat. Een samengesteld proces kan bijvoorbeeld gedeeltelijk slagen in een CRM en vervolgens falen in een ERP. Zonder compenserende rollback-transacties blijven entiteiten half voltooid achter. Die onvolledige toestand leidt tot stille datavervuiling: de systemen lijken ieder afzonderlijk bruikbaar, terwijl zij onderling niet meer dezelfde werkelijkheid representeren.
In zulke situaties is het niet voldoende om alleen de succesvolle keten te toetsen. De validatie moet vaststellen welke lokale wijziging vastligt, welk uitgaand bericht nog verzonden moet worden en wanneer een externe verwerking als definitief kan gelden. Het Transactional Outbox-patroon biedt hiervoor een afgebakend mechanisme: lokale databasemutaties en uitgaande API-berichten worden binnen één ACID-transactie vastgelegd. Asynchrone workers verzenden de berichten pas nadat de lokale dataconsistentie is veiliggesteld. Dat maakt dit patroon vooral relevant wanneer een lokale processtap en een uitgaande melding niet los van elkaar mogen ontsporen.
Ook tijdelijke uitval maakt validatie noodzakelijk wanneer veel processen dezelfde externe API gebruiken. Herhaalpogingen verkorten soms de onderbreking voor een individuele mutatie, maar kunnen bij gelijktijdige fouten een nieuwe belastinggolf vormen. Gecontroleerde retries combineren daarom exponentiële backoff met jitter: de wachttijd neemt toe en wordt niet voor alle processen identiek. Bij de validatie staat dan centraal of deze spreiding tijdens herstel daadwerkelijk zichtbaar blijft.
De praktische grens ligt dus bij de gevolgen van een afwijking. Raakt een fout uitsluitend een losstaande, opnieuw uit te voeren raadpleging, dan is de vereiste validatie beperkter. Ontstaat er daarentegen een blijvende gegevensmutatie, een keten tussen CRM en ERP, of een gedeelde externe afhankelijkheid, dan vraagt go-live om toetsing van gedeeltelijk succes, vertraagde levering en gedoseerd herstel. De normale verwerking zegt in die situaties te weinig over de operationele uitkomst.
Belangrijkste factoren voor continuïteitsvalidatie
De acceptatiecriteria volgen uit de manier waarop de integratie gegevens verwerkt, hoe lang zij afhankelijk mag zijn van gekoppelde systemen en hoe zij afwijkende berichten afhandelt. Onderstaande factoren maken de keuzes expliciet, zodat een go-livebesluit niet uitsluitend op een werkend normaal pad rust.
| Factor | Wat de validatie moet uitwijzen | Beslisimplicatie |
|---|---|---|
| Consistentie tegenover ketenbeschikbaarheid | Bij realtime synchrone tweeweg-validatie wordt direct duidelijk of gegevens overeenkomen. Tegelijk daalt de totale beschikbaarheid van de keten naar het product van alle gekoppelde systemen. | Beoordeel per proces of directe bevestiging nodig is, of dat een andere verwerking past bij de aanvaardbare afhankelijkheid van externe systemen. De test moet aantonen welk gedrag optreedt wanneer één schakel niet beschikbaar is. |
| Ongeldige berichten in de verwerking | Een syntactisch valide maar semantisch ongeldige payload kan een worker-pool herhaaldelijk laten falen. Zonder routering naar een Dead Letter Queue kunnen duizenden volgende, wel valide berichten urenlang geblokkeerd raken. | Maak afhandeling van een foutief afzonderlijk bericht een zelfstandig acceptatiecriterium. Het bewijs moet laten zien dat de gewone berichtstroom verdergaat terwijl het afwijkende bericht is geïsoleerd. |
| Gefaseerde uitrol tegenover snelle marktintroductie | Validatie per leverancier op geanonimiseerde data en passief schaduwdraaien verlengt het traject. Daartegenover staat dat een big-bang lancering risico’s introduceert die vooraf niet beheersbaar zijn gemaakt. | Kies de uitrolvorm op basis van de gevolgen van een fout. Per fase ontstaat concreet bewijs over de verwerking onder realistische gegevens, voordat de volgende groep aansluit. |
Een gestructureerde aanpak voor continuïteitsvalidatie
Een bruikbare validatieaanpak verdeelt de test rond afzonderlijke faal- en herstelgedragingen. Daarmee wordt per onderdeel duidelijk welk bewijs voor go-live ontbreekt en welke afwijking de reguliere verwerking mag raken.
- Toets herhaalde mutaties als één verwerkingsresultaat. Bouw voort op het eerder beschreven timeoutscenario door een muterende aanroep te versturen en het netwerkantwoord gecontroleerd te laten ontbreken. Bied daarna dezelfde aanvraag opnieuw aan met dezelfde Idempotency-Key. Leg als acceptatiebewijs vast dat geen tweede mutatie is ontstaan en dat het eerdere verwerkingsresultaat of de bijbehorende status terugkomt. Zo blijft de test gericht op het onderscheid tussen een transportfout en een nieuwe bedrijfsactie.
- Isoleer permanent falende berichten. Bied een bericht aan dat niet herstelt door opnieuw proberen en controleer of het naar een Dead Letter Queue gaat. De vastgelegde foutcontext, payload en correlatie-ID’s vormen de basis voor onderzoek en herverwerking. Tegelijk moet de reguliere berichtstroom doorgaan. Deze test scheidt twee vragen die vaak door elkaar lopen: kan een medewerker of beheerteam het foutieve bericht reconstrueren, en blijven opvolgende geldige berichten beschikbaar voor verwerking?
- Test herstel onder terugkerende aanvraagdruk. Simuleer falende API-aanroepen en daarna herstel van de externe interface. Controleer in de testruns de wachttijden, spreiding en maximale hoeveelheid herhaalpogingen rond het herstelmoment. Daarmee wordt aantoonbaar of de ingestelde backoff en jitter de opgestapelde aanvraagdruk verdelen, in plaats van uitsluitend dat een individuele aanvraag uiteindelijk slaagt.
Veelgestelde vragen over continuïteitsvalidatie
Veel organisaties hebben gerichte vragen over de manier waarop continuïteitsvalidatie voor API-integraties wordt uitgevoerd en welke bewijslast daadwerkelijk relevant is voor besluitvorming. Hieronder vindt u antwoorden op veelvoorkomende vragen en bezwaren:
- “Leiden retries niet tot extra risico op overbelasting?” Het automatisch opnieuw proberen van mislukte verzoeken kan bij kortdurende verstoringen de beschikbaarheid verhogen, maar zonder begrenzing of backoff-strategie ontstaat het risico dat een externe dienst juist verder wordt belast. In een valide testplan wordt daarom zichtbaar hoe de integratie omgaat met herhaalde verzoeken tijdens een storing, inclusief de afweging tussen snelle herstelpogingen en het voorkomen van HTTP 429-blokkades of kettingreacties. Beoordeel daarbij de gemeten spreiding en begrenzing van de retries, niet alleen het uiteindelijke succes van een verzoek.
- “Is een technische testrun voldoende als bewijs voor go-live?” Een enkele technische test toont doorgaans alleen aan dat een fout kan worden gesimuleerd. Voor operationele besluitvorming is aanvullend bewijs nodig: een gevalideerd runbook met geteste rollback-procedures, documentatie van handmatige herverwerking van Dead Letter Queues en vastgelegde hersteltijden in een representatieve testomgeving. Dit geeft inzicht in zowel het herstelproces als de praktische uitvoerbaarheid ervan, zodat technische en operationele stakeholders kunnen beoordelen of de continuïteit daadwerkelijk is geborgd.
- “Waarom vooraf testen met eigen data en per use-case?” Door vooraf per use-case te definiëren welke scenario’s en uitzonderingen relevant zijn, en deze te toetsen op eigen data, wordt de validatie concreet en toetsbaar. Een Proof of Concept op realistische gegevens maakt zichtbaar of het proces voldoet aan de eisen van de organisatie. Als blijkt dat bepaalde acceptatiecriteria niet haalbaar zijn, blijft het mogelijk om op basis van deze bevindingen een weloverwogen besluit te nemen om het traject bij te sturen of te stoppen. Zo wordt validatie een afgebakend onderdeel van de besluitvorming, niet slechts een technische formaliteit.
Belangrijke overwegingen voor go-live goedkeuring
Go-livegoedkeuring wordt verdedigbaar wanneer de technische werking, het herstelbewijs en de eigenaarschapgrenzen als één besluitstuk beschikbaar zijn. Twee onderdelen maken daarbij duidelijk wat de organisatie daadwerkelijk accepteert en wie handelt als de keten afwijkt.
- Een getoetste Continuity Test Matrix. Leg specifieke storingsscenario’s, waaronder 504 Gateway Timeouts, DNS-fouten, netwerk-jitter en rate limits, rechtstreeks naast geslaagde testruns en meetbare herstelcriteria op representatieve data. Deze matrix voorkomt dat “getest” een algemene status wordt. Per scenario is dan zichtbaar welke onderbreking is nagebootst, welk herstelgedrag is vastgesteld en of het resultaat aan de vooraf bepaalde grens voldoet. Voor de goedkeurder ontstaat daarmee een controleerbare koppeling tussen het risico dat het proces loopt en het bewijs dat daarvoor is geleverd.
- Een formele RACI voor de volledige keten. Leg vast waar de integratie- en bufferverantwoordelijkheid van de Laravel-laag eindigt, en waar data-eigenaarschap en externe API-SLA’s beginnen. Dit voorkomt dat een fout na go-live tussen partijen blijft hangen omdat ieder team veronderstelt dat een ander team de gegevens, de wachtrij of de externe beschikbaarheid beheert. De RACI moet daarom niet alleen namen bevatten, maar ook de grens tussen verantwoordelijkheden bij storing en herstel helder maken. Dit is geen vervanging voor contractuele of complianceverplichtingen, maar een praktisch verificatiemiddel bij periodieke reviews van testruns, runbooks en beschikbare auditrapportages. Zonder die grens kan een technisch geslaagde integratie alsnog leiden tot vertraging in de dagelijkse operatie, herstelkosten en onduidelijkheid over wie een vastgelopen proces weer in beweging brengt.