
Een startup kan een AI-product snel lanceren wanneer de data-invoer aan vooraf vastgelegde validatiecriteria voldoet, zoals schema-validatie en een getrapte review-workflow. Perfecte datakwaliteit is daarvoor niet nodig; afwijkende of onzekere invoer moet wel zichtbaar buiten de automatische route blijven.
Datagereedheid voor AI-lanceringen bij startups
Bij een AI-lancering gaat datagereedheid om de vraag of gegevens gecontroleerd door het product kunnen stromen. Startups hebben daarvoor duidelijke validatiecriteria en een beheersbare verwerkingsworkflow nodig.
- Zorg voor schema-validatie om consistente datastructuren te waarborgen en onverwachte invoer te identificeren.
- Implementeer een 'eerst lezen, dan schrijven'-principe om datamutaties te valideren tegen authentieke bronnen.
- Beperk autonomie tot controleerbare gevallen om operationele risico's te minimaliseren.
- Maak gebruik van een getrapte review-workflow om menselijke tussenkomst mogelijk te maken bij twijfelachtige data.
- Observeer en monitor waar validatie tekortschiet om de workflow gericht aan te passen.
Belang van datagereedheid voor AI-productlanceringen
Een AI-productlancering wordt niet alleen bepaald door de keuze voor een model of de snelheid waarmee een Laravel-MVP wordt gebouwd. De gegevensstroom bepaalt mede of de toepassing onder echte bedrijfsomstandigheden voorspelbaar reageert. Datagereedheid betekent niet dat ieder bronrecord vooraf perfect, volledig of uniform moet zijn. Wel moet de applicatie herkennen welke invoer binnen de afgesproken scope valt en welke afwijkt, ontbreekt of nadere beoordeling vraagt.
Dat onderscheid is operationeel relevant. Een AI-toepassing ontvangt geen abstracte dataset, maar velden die een vervolgactie kunnen sturen: een antwoord, classificatie, voorstel of mutatie. Wanneer verplichte informatie ontbreekt of een veld een onverwachte vorm heeft, kan een model het ontbrekende patroon zelf proberen in te vullen. Zo wordt een dataprobleem een productuitkomst die plausibel kan lijken, maar niet op de aangeleverde gegevens rust. Voor een startup is dat een ongunstig vertrekpunt: de eerste gebruikerservaring, interne controle en verdere productbeslissingen steunen dan op onvoldoende afgebakende invoer.
De praktische grens ligt aan de ingang van de applicatie. Deterministische schema-validatie kan daar consistente datastructuren afdwingen. Met JSON Schema's of form requests wordt vooraf gecontroleerd of verwachte velden aanwezig zijn en het afgesproken formaat volgen. In een Laravel-gebaseerde MVP maakt die controle het verschil tussen gegevens die gecontroleerd naar een AI-stap mogen en gegevens die expliciet worden afgewezen of apart worden behandeld. Het model hoeft gaten in de invoer dan niet zelf te dichten.
Datagereedheid is daarmee geen uitstelreden voor een eerste release, maar een manier om de releasegrens scherp te maken. De startup kan leren van geldige, herkenbare invoer zonder iedere uitzonderlijke variant al te ondersteunen. Afwijkende invoer wordt vroeg zichtbaar, zodat duidelijk blijft of een uitkomst voortkomt uit de productlogica of uit data die niet aan de verwerkingsvoorwaarden voldeed.
Risico's van gemiste datacontroles
Een gemiste datacontrole heeft vaak pas gevolgen nadat een AI-product een uitkomst heeft gegeven. Dat maakt de fout lastig te herleiden: was de analyse onjuist, was de bron al verouderd, of is een voorstel als feit behandeld? Voor een startup die snel wil lanceren, ontstaat vertraging juist wanneer dit onderscheid achteraf moet worden uitgezocht. Gebruikers zien dan een resultaat, terwijl het team nog moet vaststellen of de gegevens waarop dat resultaat steunt wel de juiste waren.
Het risico neemt toe zodra een AI-toepassing niet alleen leest, maar ook wijzigingen voorstelt die in bedrijfsgegevens terechtkomen. Als een voorgestelde mutatie rechtstreeks wordt opgeslagen, kan de applicatie afwijken van de bron die binnen het proces als waarheid geldt en bestaande bedrijfsregels passeren. Een fout is dan niet meer alleen zichtbaar in de AI-uitkomst, maar kan terugkomen in vervolgwerk, rapportage of gegevens waarop medewerkers verder bouwen.
Daarom vormt het principe ‘eerst lezen, dan schrijven’ een duidelijke controlegrens. De AI-stap kan gegevens raadplegen en een wijziging voorstellen, maar de voorgestelde mutatie wordt vóór opslag getoetst aan het authentieke bronsysteem en de bestaande domeinregels. De bron is daarmee niet alleen de herkomst van data, maar ook het referentiepunt voor de vraag of een voorgestelde actie klopt.
Voor de eerste release betekent dit dat de AI-functie bruikbaar kan zijn zonder dat iedere voorgestelde wijziging automatisch wordt doorgezet. De handeling met de grootste operationele impact blijft achter een controle. Zo blijft een fout voorstel zichtbaar als voorstel, in plaats van als feit in de bedrijfsdata.
Essentiële datacontroles voor AI-lanceringen
Schemawijzigingen zijn een concreet risico bij koppelingen met bronsystemen. Een veldnaam kan wijzigen, een datum kan in een ander formaat binnenkomen of een eerder verwacht onderdeel kan verdwijnen. Wanneer de koppeling zulke veranderingen zonder controle accepteert, komt de afwijking als ogenschijnlijk normale invoer in de applicatie terecht.
Dit patroon staat bekend als Schema Drift Blindness. De koppeling met een dynamisch bronsysteem blijft technisch bestaan, terwijl de betekenis en structuur van de ontvangen gegevens ongemerkt kunnen verschuiven. Voor een AI-product is het daarom niet genoeg om te controleren of er data binnenkomt; de data moet nog aan het afgesproken contract voldoen. Een waarde in een veld is niet automatisch bruikbaar wanneer het veld zelf van naam, structuur of formaat is veranderd.
Geautomatiseerde contractvalidatie maakt die grens expliciet. Een afwijkende veldnaam of datumindeling wordt dan niet stilzwijgend doorgelaten als verkeerd geïnterpreteerde data, maar levert een zichtbaar signaal op dat de invoer buiten de productafspraak valt. De eerste release kan zich daardoor richten op invoervarianten die daadwerkelijk worden herkend, zonder schijnbare dekking te bieden voor ongecontroleerde bronvarianten.
De relevante vraag is dus niet of alle systemen foutloze data bevatten, maar of de AI-functie uitsluitend gegevens verwerkt waarvan de structuur nog overeenkomt met wat de applicatie verwacht. Afwijkingen kunnen dan afzonderlijk worden behandeld zonder de hele MVP te blokkeren.
Checklist voor datagereedheid bij AI-lanceringen
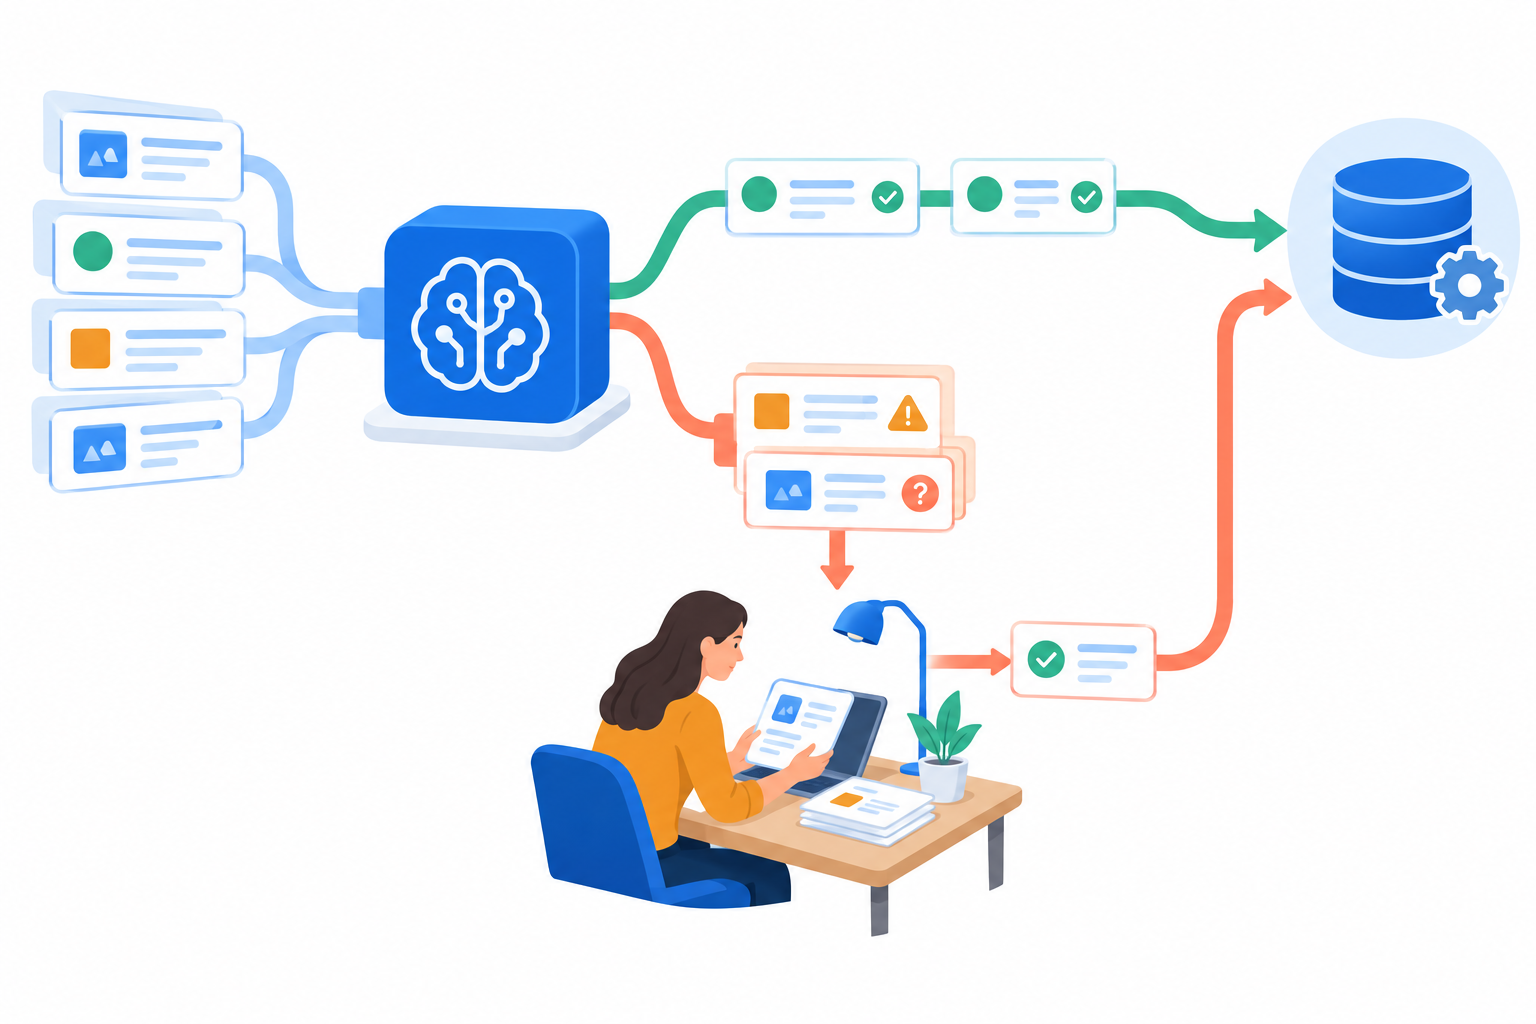
Deze checklist richt zich op de hoeveelheid autonomie die de eerste release werkelijk aankan. De controle is geslaagd wanneer het team niet alleen weet wat de AI verwerkt, maar ook welke uitkomsten zonder menselijke tussenkomst mogen doorstromen en welke niet.
- Bepaal of menselijke beoordeling onderdeel van de eerste release blijft. Leg vast welke gevallen de AI als voorstel afhandelt en wanneer een medewerker de uitkomst beoordeelt voordat deze effect krijgt in het bedrijfsproces. Een getrapte review-workflow houdt twijfelachtige invoer of uitkomsten buiten de automatische route. Daarmee wordt de datadrempel voor een MVP realistischer: uitzonderingen hoeven niet direct autonoom te worden afgehandeld. Gebruik de beoordelingen vervolgens om te zien welke gevallen vaak terugkomen en voldoende voorspelbaar zijn om later opnieuw voor automatisering te beoordelen. De opbrengst is niet dat elke uitkomst juist is, maar dat de toepassing een gecontroleerde route heeft voor situaties waarin de gegevens geen veilige autonome afhandeling toelaten.
Veelvoorkomende fouten bij datacontroles
Bij de lancering van een AI-product vallen vooral twee fouten op die controle achteraf onnodig moeilijk maken:
- Gebrek aan herleidbaarheid van AI-uitkomsten. Als een AI-advies of geëxtraheerd veld niet direct te koppelen is aan het specifieke brondocument of bronrecord, kan de zakelijke gebruiker niet controleren waarop het resultaat is gebaseerd. Dit maakt het lastig om bij twijfel snel te verifiëren of een uitkomst door de juiste bron wordt ondersteund. Door herleidbaarheid standaard te maken—waarbij de gebruiker met één klik de onderliggende bron kan openen—wordt controle onderdeel van het werkproces in plaats van een onderzoek achteraf. Dit voorkomt niet alle invoerfouten, maar maakt fouten wel direct onderzoekbaar. Voor een eerste AI-product ontstaat vertrouwen doordat uitkomsten controleerbaar blijven, niet doordat het systeem altijd overtuigend lijkt.
- Afwijkende invoer stilzwijgend accepteren. Wanneer gewijzigde veldnamen, ontbrekende waarden of onverwachte formaten zonder validatie doorstromen, is niet meer duidelijk of de AI op de bedoelde gegevens werkt. Schema-validatie en zichtbare afhandeling van afwijkingen voorkomen dat een technisch werkende koppeling wordt verward met betrouwbare invoer.
Toepassen van datacontroles in de praktijk
Begin met een expliciete werkgrens, niet met de belofte dat de AI allerlei invoer aankan. Leg vooraf vast welk resultaat de toepassing moet leveren, hoe dat resultaat wordt beoordeeld en welke fouttolerantie binnen de eerste scope acceptabel is. Die meetlat geeft het team een toetsbare basis voor de vraag of beschikbare data voldoende is voor de beoogde functie.
Documenttypen of invoervarianten die buiten de initiële scope vallen, hoeven niet als incidentele randgevallen te worden behandeld die de AI ‘waarschijnlijk’ ook kan verwerken. Zij horen expliciet buiten de productgrens te vallen. Zo hoeft een MVP niet in de praktijk onbeperkt veel datavormen te interpreteren, terwijl zij op papier slechts één functie heeft. Betrokkenen weten dan welke gegevens wel binnen de beoordeling vallen en welke niet.
Pas daarna wordt duidelijk welke uitbreiding zinvol is. In plaats van te wachten tot ieder bronbestand geschikt lijkt, kan een startup toetsen of een afgebakende set invoervarianten aan de meetlat voldoet. Afwijkingen worden niet weggemoffeld in het gemiddelde resultaat, maar als buiten scope geclassificeerd. Een nieuwe variant kan pas aan de automatische route worden toegevoegd nadat deze afzonderlijk tegen dezelfde grens is beoordeeld.
Voor een Laravel-gebaseerde MVP levert dit productmatige helderheid op. De applicatie hoeft niet te doen alsof zij alle data begrijpt, maar kan onderscheid maken tussen invoer die voor de afgesproken functie wordt geaccepteerd en invoer die niet binnen de eerste versie valt.
Veelgestelde vragen over datacontroles
De meest gehoorde vraag gaat niet over de techniek, maar over de grens tussen een snelle MVP en onverantwoord automatische verwerking. Die grens ligt bij de manier waarop onzekere data door het proces beweegt.
- Moet een startup wachten tot alle data schoon is voordat een AI-product kan lanceren?
Niet per se. De relevante vraag is of de eerste release gevallen met onzekere of onzuivere data kan opvangen zonder deze volledig autonoom te verwerken. De AI kan verwerken wat binnen de gekozen route past, terwijl twijfelgevallen beschikbaar blijven voor menselijke beoordeling.
Datagereedheid staat dus niet gelijk aan volledige autonomie. Een eerste product kan bruikbaar zijn wanneer het duidelijk onderscheid maakt tussen uitkomsten die mogen doorstromen en uitkomsten die eerst bekeken worden. De menselijke stap is dan een expliciete begrenzing van de automatisering. Wanneer het team ziet welke gevallen regelmatig bij beoordeling belanden, kan het beslissen of uitbreiding van de automatische route gerechtvaardigd is. Zolang die zekerheid ontbreekt, houdt menselijke beoordeling de impact van onzuivere data beperkt.
Belangrijkste overwegingen voor datagereedheid
Datagereedheid bij een AI-lancering draait om een expliciete grens voor verantwoorde automatisering. Niet elk procesdeel is geschikt voor volledige autonomie en de gevolgen van fouten verschillen per geval. Voor een beheersbare eerste release zijn deze overwegingen bepalend:
- Beperk autonomie tot controleerbare gevallen. Laat alleen uitkomsten automatisch doorstromen wanneer invoer, regels en verwachte vervolgactie binnen de afgesproken grens vallen.
- Maak de beoordelingsroute expliciet. Leg vooraf vast welke situaties menselijke tussenkomst vereisen, zodat onzekere gevallen niet alsnog ongemerkt een bedrijfsproces beïnvloeden.
- Observeer waar validatie tekortschiet. Gebruik de eerste release om te zien waar data-afwijkingen of schemawijzigingen optreden. Dat biedt een gerichte basis om de workflow aan te passen en pas daarna verdere automatisering te overwegen.
Zo wordt automatisering toegepast waar de invoer aantoonbaar binnen de productgrens valt en worden afwijkingen tijdig opgevangen. Volledige autonomie is pas aan de orde wanneer de data in de praktijk stabiel en controleerbaar blijkt.
Volgende stappen voor datagereedheid
Voor een verantwoorde AI-lancering is het noodzakelijk om expliciet te bepalen welke gegevens direct geautomatiseerd verwerkt mogen worden en waar een menselijke beoordeling vereist blijft. Door deze grens vooraf vast te leggen, voorkomt u dat onduidelijke of inconsistente data onbedoeld doorstroomt naar bedrijfsprocessen. Een gefaseerde aanpak, waarbij een Proof of Concept op eigen data de werkelijke variatie en uitzonderingen zichtbaar maakt, helpt om operationele risico's te beperken voordat verdere integratie of opschaling plaatsvindt. Zo blijft de eerste release beheersbaar en wordt het risico op ongecontroleerde fouten in bedrijfsdata geminimaliseerd, zelfs als volledige automatisering op termijn het doel is.