
Selectieve Laravel-ondersteuning is geschikt voor systemen die architecturaal losgekoppeld zijn van kernsystemen en waar de interne IT-capaciteit voldoende is voor monitoring en triage. Breder managed eigenaarschap is nodig als de interne IT-bandbreedte tekortschiet voor leveranciersafstemming en logginganalyse.
Evaluatie van Laravel-ondersteuningsopties
Bij het kiezen tussen selectieve Laravel-ondersteuning en breder managed eigenaarschap spelen verschillende factoren een rol. Het is belangrijk om de juiste balans te vinden tussen interne capaciteit en externe ondersteuning om de continuïteit te waarborgen.
- Beoordeel of de applicatie architecturaal losgekoppeld is van kernsystemen om selectieve ondersteuning mogelijk te maken.
- Evalueer de interne IT-capaciteit voor het zelfstandig uitvoeren van monitoring en triage.
- Overweeg breder eigenaarschap als interne IT niet voldoende bandbreedte heeft voor coördinatie en analyse.
- Identificeer afhankelijkheden tussen systemen die de keuze voor een bredere supportscope kunnen beïnvloeden.
Wanneer is selectieve Laravel-ondersteuning voldoende?
Selectieve Laravel-ondersteuning is niet hetzelfde als beperkt beheer zonder gevolgen. Het is een passende afbakening wanneer één maatwerksysteem voldoende zelfstandig kan functioneren en incidenten binnen een herkenbare technische grens blijven. Die grens ontstaat wanneer de applicatie architecturaal losgekoppeld is van kernsystemen: gegevensuitwisseling loopt dan via asynchrone interfaces en circuit breakers beperken de doorwerking van fouten. Een probleem in een afhankelijk systeem hoeft daarmee niet automatisch het volledige Laravel-systeem te blokkeren. De supportvraag kan dan gericht blijven op de applicatielaag, zonder dat één partij de dagelijkse verantwoordelijkheid voor de hele keten hoeft over te nemen.
De architectuur alleen bepaalt de haalbaarheid echter niet. Selectieve ondersteuning verplaatst een deel van de operationele verantwoordelijkheid naar de interne organisatie. Die moet voldoende technische capaciteit hebben om monitoring te volgen, een incident te duiden en vast te stellen welke leverancier als eerste in actie moet komen. Ook leverancierstriage blijft dan intern belegd: iemand moet kunnen beoordelen of een afwijking in de Laravel-applicatie, een koppeling of een ander systeem thuishoort. Dit vraagt niet alleen beschikbare uren, maar ook het vermogen om tijdens een incident regie te voeren.
De praktische toets is daarom dubbel. Ten eerste: kan de applicatie een storing in een afhankelijk systeem opvangen zonder dat de bedrijfsvoering direct vastloopt? Ten tweede: kan het interne team de signalen, herstelacties en afstemming daadwerkelijk uitvoeren naast zijn andere taken? Als beide vragen positief kunnen worden beantwoord, biedt selectieve ondersteuning een heldere en proportionele scope. De Laravel-partner behandelt dan afgebakende applicatievragen, terwijl interne IT de samenhang met de rest van het landschap bewaakt.
Ontbreekt een van die voorwaarden, dan verandert een kleine storing al snel in een grensgeschil. Denk aan een probleem rond API-authenticatie waarbij een externe time-out optreedt. Na onderzoek kan een selectieve applicatiepartner vaststellen dat de oorzaak buiten de overeengekomen scope ligt, terwijl de ERP-leverancier zich op standaardconformiteit beroept. Intussen blijft interne IT verantwoordelijk voor bemiddeling en mogelijk handmatig herstel van gegevens. Selectieve ondersteuning is dus levensvatbaar bij technische isolatie én aantoonbare interne regiecapaciteit; niet enkel omdat op dat moment slechts één systeem instabiel lijkt.
De onzekerheid bij het kiezen van de juiste supportscope
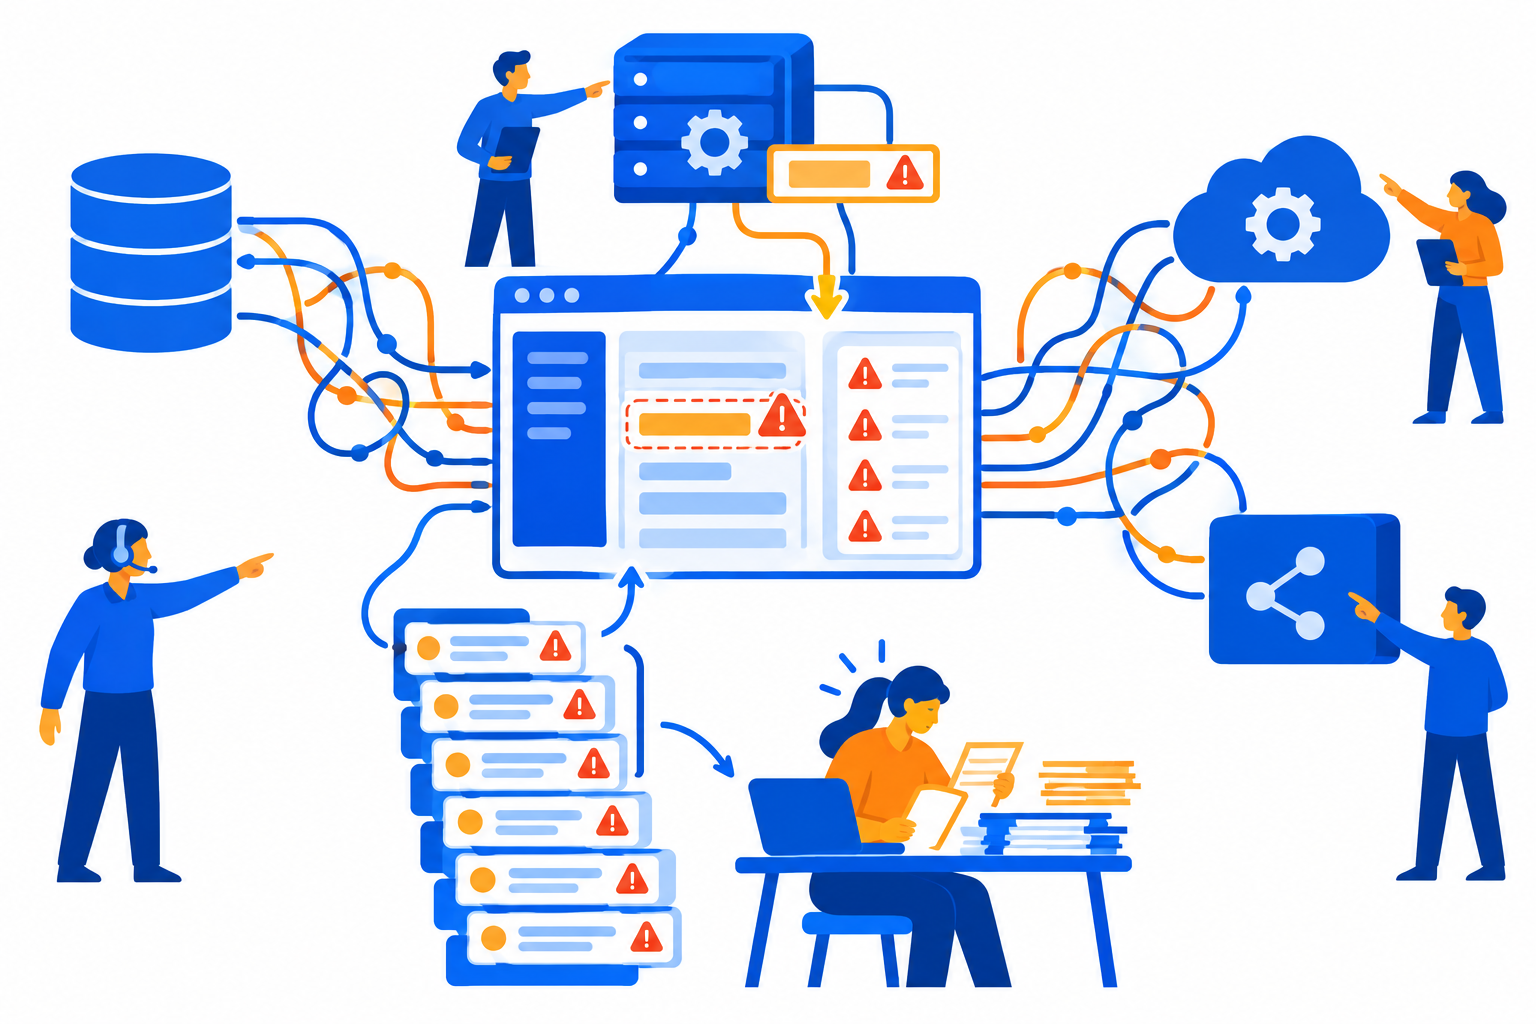
Het bepalen van de juiste supportscope voor bedrijfskritische Laravel- en maatwerkapplicaties brengt voor veel organisaties een fundamentele onzekerheid met zich mee. De aanleiding is vaak een zichtbaar incident in één systeem, maar de onderliggende vraag is breder: is het probleem werkelijk geïsoleerd, of zijn er structurele afhankelijkheden die het risico op verstoringen vergroten? In een landschap waar applicaties, ERP-systemen en externe leveranciers met elkaar verweven zijn, kan een wijziging buiten het zichtbare systeem onverwacht doorwerken naar interne processen. Een veldwijziging in een extern ERP-systeem kan bijvoorbeeld leiden tot validatiefouten in Laravel-processen, waardoor taken zich opstapelen en de operationele druk verschuift naar handmatige noodoplossingen. Het is dan niet altijd duidelijk waar het incident begint en wie verantwoordelijk is voor herstel.
Deze onzekerheid wordt versterkt wanneer meerdere leveranciers betrokken zijn, elk met een eigen afgebakende verantwoordelijkheid. Zonder centrale regie ontstaat het risico dat partijen bij grensoverschrijdende incidenten naar elkaar verwijzen, waardoor niemand het eigenaarschap voor het totale herstelproces op zich neemt. De organisatie blijft dan met formeel verdeelde contracten zitten, maar mist tijdens een storing een eenduidig aanspreekpunt voor coördinatie en voortgang. Hierdoor ontstaat besluitingsdruk: is het voldoende om alleen het meest instabiele systeem onder beheer te brengen, of vraagt de verwevenheid van systemen en leveranciers om een bredere managed continuity-aanpak? Zolang de impact van afhankelijkheden en eigenaarschap niet scherp in beeld is, blijft het lastig om te bepalen welke supportscope daadwerkelijk de continuïteit waarborgt.
Wanneer speelt de keuze tussen smalle en brede ondersteuning?
De keuze tussen selectieve ondersteuning en bredere managed continuity wordt relevant zodra de interne IT-capaciteit onvoldoende is om zowel leveranciersafstemming als logginganalyse structureel te organiseren. Dit speelt vooral in applicatielandschappen waar meerdere systemen en leveranciers met elkaar verbonden zijn en incidenten niet beperkt blijven tot één applicatie. In deze context betekent een smalle supportscope dat de interne organisatie verantwoordelijk blijft voor het coördineren van herstelacties, het analyseren van incidenten en het afstemmen tussen verschillende partijen. Wanneer de beschikbare IT-bandbreedte beperkt is, kan deze coördinatielast bij incidenten zwaarder wegen dan de besparing op een breder servicecontract. Het ontbreken van centrale regie leidt er dan toe dat schaarse interne capaciteit grotendeels wordt opgeslokt door crisistriage en leveranciersafstemming, waardoor minder tijd overblijft voor strategische digitaliseringsprojecten. De beslissing om de supportscope te verbreden ontstaat dus niet alleen uit technische complexiteit, maar vooral uit de vraag of het interne team de operationele regie daadwerkelijk kan blijven voeren zonder dat dit ten koste gaat van andere prioriteiten.
Belangrijkste criteria voor het evalueren van supportopties
Bij het beoordelen van supportopties voor Laravel- en maatwerkapplicaties zonder een volledig intern IT-team, zijn er enkele kerncriteria die bepalen of selectieve ondersteuning volstaat of dat bredere managed continuity noodzakelijk is:
- Herkomst van instabiliteit: Onderzoek of het zichtbare probleem in een applicatie daadwerkelijk daar ontstaat, of dat de oorzaak ligt in onderliggende systemen zoals databases of legacy-interfaces. Symptoomgedreven contractering – waarbij alleen het front-end wordt beheerd – kan ertoe leiden dat de werkelijke bron van instabiliteit buiten beeld blijft. Dit vergroot het risico dat incidenten blijven terugkeren, omdat de onderliggende oorzaak niet wordt aangepakt.
- Afhankelijkheden tussen systemen: Breng in kaart in hoeverre de applicatie afhankelijk is van andere systemen. Als vertragingen of storingen in gekoppelde systemen direct doorwerken naar de zichtbare applicatie, is er sprake van een ketenafhankelijkheid. In zo'n situatie is een smalle supportscope vaak onvoldoende, omdat incidenten niet binnen één beheergrens kunnen worden opgelost.
- Complexiteit van integraties: Hoe meer koppelingen en data-uitwisselingen er zijn tussen applicaties, hoe groter de kans dat incidenten zich over meerdere systemen verspreiden. Dit maakt het lastig om eigenaarschap en incidentopvolging helder te houden bij een beperkte supportscope.
- Toewijzing van verantwoordelijkheid: Evalueer of de gekozen supportscope daadwerkelijk aansluit bij de technische oorzaken van verstoringen. Wanneer verantwoordelijkheden voor onderliggende systemen of integraties buiten het contract vallen, ontstaat het risico dat niemand eigenaarschap neemt over de bron van het probleem.
Deze criteria helpen organisaties om te bepalen of selectieve ondersteuning voldoende is, of dat bredere managed continuity nodig is om coördinatieproblemen en terugkerende incidenten te voorkomen.
Een praktisch besliskader voor supportkeuzes
Gebruik de feitelijke route van een grensoverschrijdend incident als toets voor de gekozen supportscope. Het doel is niet om vooraf brede managed ownership te veronderstellen, maar om zichtbaar te maken welk werk bij een beperkt contract intern achterblijft.
- Stap 1: teken de grens van de beoogde ondersteuning. Benoem concreet dat de ondersteuning beperkt blijft tot de applicatielaag van één maatwerksysteem. Scheid die grens van hosting, de Laravel-specialist en het ERP, zodat niet alleen duidelijk is wie een wijziging uitvoert, maar ook welke onderdelen buiten de opdracht vallen. Stap 2: toets een incident dat die grens passeert. Stel vast wat er gebeurt als de oorzaak niet uitsluitend in de applicatielaag ligt. Dan ontstaat een situatie waarin meerdere partijen ieder informatie moeten aanleveren over hun eigen deel. Stap 3: wijs de interne regietaak aan. Bij selectieve ondersteuning verzorgt de interne IT-organisatie de triage tussen hostingprovider, Laravel-specialist en ERP-leverancier. Dat omvat het samenbrengen van signalen, het bewaken van de voortgang en het terugbrengen van vragen naar de partij die ze kan beantwoorden. Deze taak is een vast onderdeel van een smalle scope, niet een incidentele uitzondering. Stap 4: bepaal of die taak uitvoerbaar is. Beoordeel of die interne organisatie tijdens een grensincident voldoende ruimte heeft om de drie partijen te coördineren. Hierbij telt niet alleen technische kennis, maar ook de beschikbaarheid om de afstemming vast te houden totdat duidelijk is waar de volgende actie ligt. Stap 5: vertaal de uitkomst naar de scope. Als die regierol bewust en uitvoerbaar intern blijft, kan de ondersteuning beperkt blijven tot de applicatielaag. Als de organisatie die triage niet kan dragen, vraagt de gewenste continuïteit om een bredere verantwoordelijkheidsverdeling. De uitkomst beschrijft daarmee niet welke leverancier overal eigenaar van is, maar wie de coördinatie over de afgesproken grenzen organiseert.
Veelgestelde vragen over supportkeuzes
Deze vragen komen vaak naar voren wanneer organisaties een bestaande applicatie, een beperkt intern team en meerdere leveranciers naast elkaar moeten organiseren.
- “Is bredere ondersteuning nodig zodra er meerdere leveranciers zijn?”
Niet automatisch. Meerdere leveranciers vormen op zichzelf geen bewijs dat één partij een bredere verantwoordelijkheid moet dragen. De relevante vraag is of de grenzen tussen die leveranciers tijdens de intake expliciet kunnen worden gemaakt en of de organisatie weet wie welke werkzaamheden uitvoert. Transparante afbakening betekent dat een beheerpartner benoemt wat wel en niet binnen de scope valt. Daarmee blijft zichtbaar welke taken bij interne IT of andere leveranciers liggen, in plaats van dat de omvang van de dienstverlening onduidelijk blijft. - “Is selectieve ondersteuning een onvolledige keuze?”
Ook dat volgt niet vanzelf. Selectieve ondersteuning kan een bewuste verdeling van verantwoordelijkheden zijn wanneer interne capaciteit toereikend is voor de taken die buiten de externe scope blijven. Een eerlijk oordeel kan daarom ook zijn dat uitbesteden niet nodig is. Die uitkomst is alleen geloofwaardig als de resterende taken niet worden weggelaten: de organisatie moet kunnen zien welke verantwoordelijkheid zij behoudt en waarop de beoordeling van haar capaciteit is gebaseerd. - “Waarom moet de scope al bij de intake zo precies worden besproken?”
Omdat een beheerafspraak pas operationeel bruikbaar is wanneer grenzen vooraf begrijpelijk zijn. Tijdens een verstoring leidt een vage formulering tot discussie over wat een partij nog wel of niet oppakt. Een expliciete intake maakt het mogelijk om de ondersteuning af te bakenen zonder te doen alsof één contract alle betrokken systemen omvat. Zij maakt ook ruimte voor een beperkte opdracht wanneer die opdracht daadwerkelijk past bij de interne organisatie. - “Betekent een transparante scope dat alle risico’s zijn weggenomen?”
Nee. Transparantie vervangt geen technische of organisatorische capaciteit. Zij voorkomt vooral dat verwachtingen verborgen blijven. Door helder te benoemen wat buiten de scope valt, wordt zichtbaar welke afhankelijkheden en coördinatietaken elders belegd zijn. Dat geeft management en IT een concreter uitgangspunt om te beoordelen of de gekozen verdeling aansluit bij de beschikbare mensen en verantwoordelijkheden.
Belangrijke overwegingen bij het kiezen van de juiste supportscope
De gekozen supportscope hoeft niet in één keer definitief of maximaal breed te zijn. Een gefaseerde werkwijze maakt het mogelijk om de grens tussen selectieve ondersteuning en bredere verantwoordelijkheid te toetsen aan een concreet proces, in plaats van aan abstracte verwachtingen over dienstverlening. Daarbij verschuift het gesprek van algemene beloften naar een afgebakende vraag: welke gegevensstroom, applicatie of integratie moet aantoonbaar stabieler functioneren, en onder welke omstandigheden is de eerste fase geslaagd?
- Begin met een meetlat die bij de operationele situatie past. Leg vooraf vast wat als voldoende resultaat geldt, bijvoorbeeld foutreductie op datastromen of een livegang zonder productiestilstand. Een Proof of Concept op eigen data biedt daarbij een beperkte, toetsbare stap. De uitkomst laat zien welke aannames standhouden voordat verantwoordelijkheden, integraties of uitrol verder worden uitgebreid.
- Behandel hardening en integratie als afzonderlijke momenten in de scope. Een eerste aantoonbaar resultaat is niet hetzelfde als brede operationele verantwoordelijkheid. Door deze onderdelen zichtbaar na elkaar te plaatsen, blijft duidelijk wanneer de opdracht verschuift van beproeven naar het verstevigen van de oplossing en het verbinden met de bestaande omgeving. Dat voorkomt dat een proef automatisch wordt uitgelegd als een toezegging over alle systemen eromheen.
- Gebruik gefaseerde uitrol om de eigenaarsgrens te bevestigen. Iedere fase maakt concreet wie beoordeelt, wie uitvoert en welke succesnorm geldt. Daarmee wordt niet alleen de techniek getoetst, maar ook de praktische verdeling tussen interne organisatie en externe ondersteuning. Blijkt in een fase dat interne regie de beoogde continuïteit niet kan dragen, dan is dat een onderbouwd signaal om de scope opnieuw te bepalen. Blijkt de verdeling wel werkbaar, dan hoeft bredere ownership niet op voorhand te worden aangenomen.
- Laat meetbare uitkomsten zwaarder wegen dan algemene SLA-taal. Een vooraf vastgelegde norm maakt bespreekbaar of de gekozen ondersteuning aansluit op het proces dat beschermd moet worden. Dat geeft een financiële en operationele begrenzing aan de volgende stap: uitbreiding is alleen te rechtvaardigen wanneer de proef of uitrol duidelijk maakt welke extra verantwoordelijkheid nodig is. Zonder die grens kan een bredere scope kosten toevoegen zonder dat helder is welk procesrisico daarmee wordt afgedekt.