
Om de voordelen van business intelligence in de gezondheidszorg te maximaliseren, begin je met semantische harmonisatie van gegevens uit verschillende systemen. Gebruik een modulaire API-laag om gericht inzichten op te leveren zonder volledige systeemintegratie. Beperk gefragmenteerde data met duidelijke architectuur- en standaardafspraken, en toets de eerste gegevensstroom met een Proof of Concept op datakwaliteit, herleidbaarheid en toegangsbeveiliging.
Maximaliseer BI-voordelen in de zorg
Het implementeren van business intelligence in de gezondheidszorg vraagt om een gerichte aanpak: maak gegevens uit verschillende systemen vergelijkbaar, kies een afgebakend proces en leg afspraken over kwaliteit, toegang en uitbreiding vroeg vast.
- Zorg voor semantische harmonisatie om gegevens uit verschillende systemen consistent te maken.
- Gebruik een modulaire API-laag voor gerichte BI-inzichten zonder volledige integratie.
- Beperk de initiële scope, zodat niet alle verspreide data tegelijk onderdeel wordt van het project.
- Start met een Proof of Concept om datakwaliteit, herleidbaarheid en consistentie te toetsen.
- Leg architectuur-, standaard- en toegangsafspraken vast voordat volgende bronnen worden aangesloten.
Waarom semantische harmonisatie cruciaal is voor BI in de zorg
Business Intelligence in de zorg begint niet bij een dashboard, maar bij de betekenis van de gegevens die daarin samenkomen. Zorginformatie staat vaak in verschillende systemen, zoals een EPD, roostersoftware en facturatie. Die systemen kunnen op het eerste gezicht gegevens over hetzelfde onderwerp bevatten, terwijl de gebruikte begrippen, registratiewijzen of coderingen uiteenlopen. Een rapport dat deze gegevens uitsluitend technisch samenvoegt, creëert daarmee nog geen betrouwbare basis voor vergelijking.
Semantische harmonisatie brengt die betekenis op één lijn. Zorginformatiebouwstenen, vaak aangeduid als zibs, beschrijven gestandaardiseerde zorginhoudelijke gegevensconcepten, zoals een observatie of zorgprobleem; ze vervangen de bronregistratie niet, maar helpen systemen dezelfde begrippen eenduidig te interpreteren. Samen met gestandaardiseerde coderingen maken zibs gegevens uit heterogene systemen beter vergelijkbaar. Voor BI in de zorg is dat het verschil tussen een overzicht waarin meerdere bronnen zichtbaar zijn en een rapportage waarin uitkomsten daadwerkelijk op dezelfde definitie rusten.
Dit speelt vooral wanneer management of operatie informatie uit verschillende processen wil combineren. Een begrip dat in het EPD anders wordt vastgelegd dan in roostersoftware of facturatie, kan zonder harmonisatie tot uiteenlopende tellingen of onverklaarbare verschillen leiden. De rapportage lijkt dan volledig, maar de onderliggende vergelijking is niet eenduidig. Dat ondermijnt de bruikbaarheid van een BI-uitkomst, omdat de lezer niet kan vaststellen of verschillen voortkomen uit de zorgprocessen zelf of uit verschillen in registratie.
De strategische grens ligt dus vóór de keuze voor visualisaties of rapportagevormen. Eerst moet helder zijn welke zorgbegrippen in de betrokken systemen worden gebruikt en welke gestandaardiseerde betekenis daarvoor geldt. Zibs bieden hiervoor een gemeenschappelijke semantische basis en beperken de interpretatieruimte die ontstaat wanneer afzonderlijke systemen elk hun eigen taal hanteren.
Semantische harmonisatie vervangt geen brondata en lost ook niet automatisch alle kwaliteitsvragen op. Wel maakt zij een noodzakelijke vorm van vergelijkbaarheid mogelijk: dezelfde zorgbegrippen krijgen in de BI-keten dezelfde betekenis, ongeacht uit welk betrokken systeem de gegevens afkomstig zijn. Daarmee wordt het gesprek over afwijkende uitkomsten concreter. De vraag verschuift van „welk dashboard heeft gelijk?” naar „welke definitie en codering ligt onder deze uitkomst?”. Voor een organisatie met verspreide zorgdata vormt die verschuiving het uitgangspunt voor rapportages die tussen processen en systemen consistent kunnen worden gelezen.
Hoe een modulaire API-laag snelle BI-waarde kan leveren
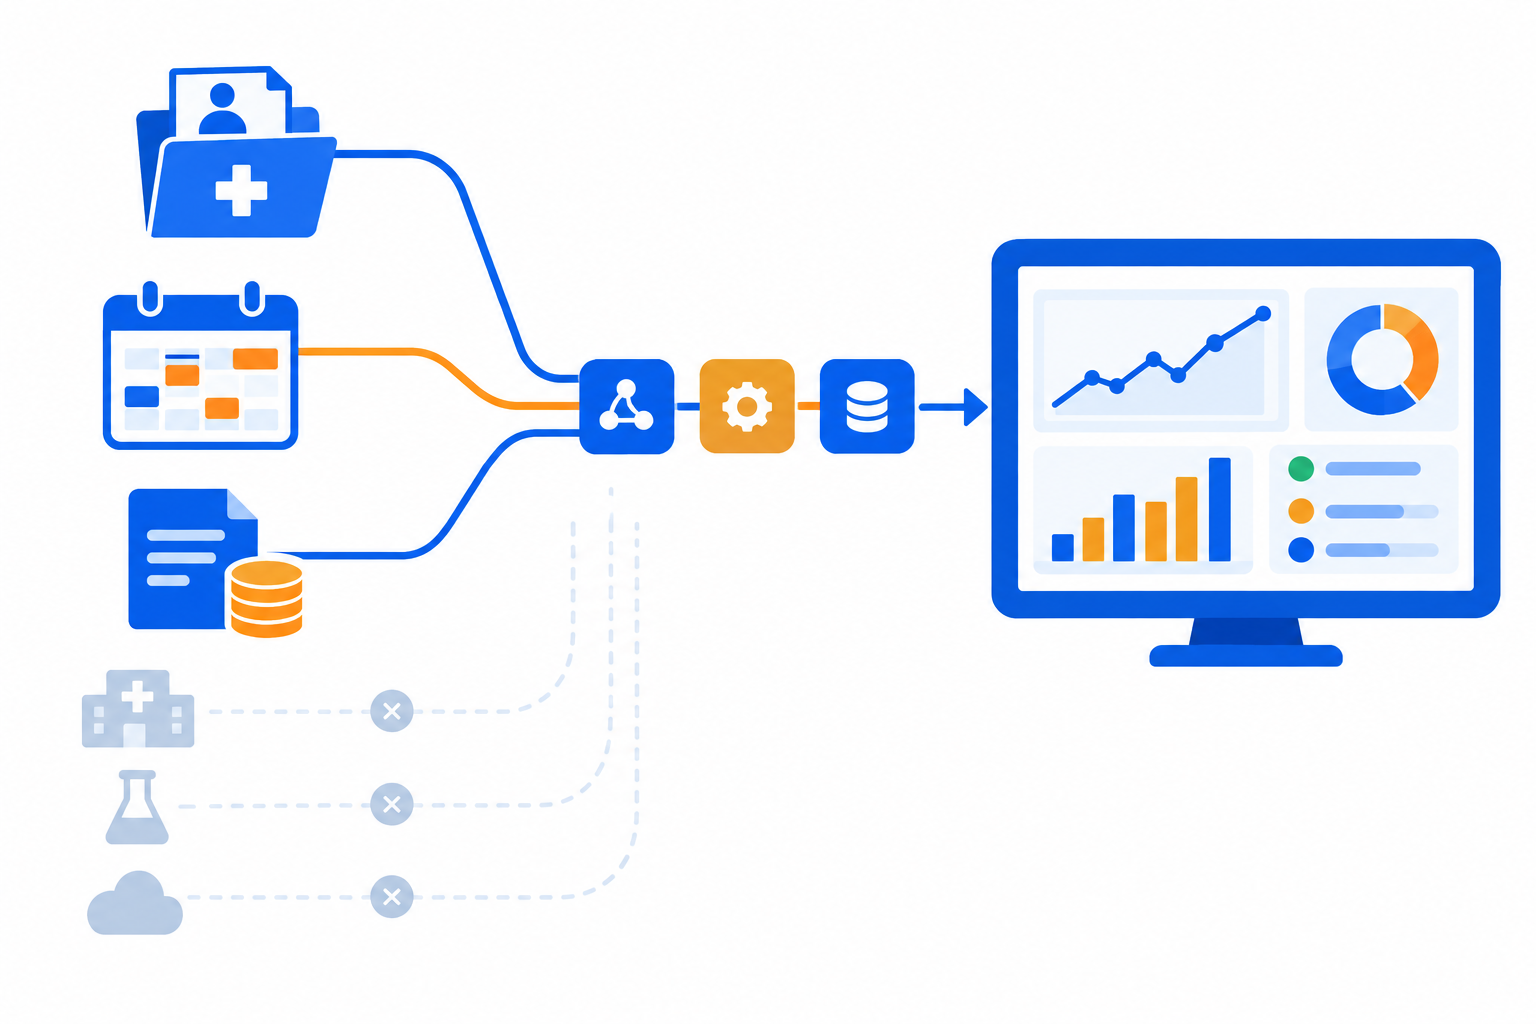
Een modulaire API-laag maakt het mogelijk om snel dashboards te realiseren voor een specifiek zorgproces, zelfs wanneer data verspreid is over meerdere systemen. Door alleen de noodzakelijke bronnen voor één concrete informatievraag te ontsluiten, ontstaat binnen enkele weken inzicht zonder dat direct een volledig nieuw datalandschap nodig is. Dit beperkt de initiële scope en voorkomt dat de organisatie direct wordt geconfronteerd met de complexiteit van volledige systeemintegratie.
De versnelling blijft alleen bruikbaar wanneer elke koppeling binnen duidelijke architectuurafspraken en standaarden past. Iedere nieuwe aansluiting voegt een transformatie toe aan het landschap. Leg daarom vast welke gegevens worden uitgewisseld, welke betekenis zij hebben en waar de transformatie plaatsvindt. Zo blijft de API-laag een herbruikbare verbinding voor afgebakende informatievragen, in plaats van een verzameling losse koppelingen die later moeilijk te beheren is.
Risico's van gefragmenteerde data voor BI-projecten
Gefragmenteerde data raakt niet alleen de vergelijkbaarheid van cijfers, maar ook de herleidbaarheid ervan. Verschillen in definities, registratiewijzen of actualiteit tussen bronsystemen kunnen ertoe leiden dat een uitkomst niet eenvoudig terug te voeren is naar de bron, de toegepaste transformaties en de gebruikte definitie. Zonder een formeel datakwaliteitskader met vastgelegde controles, eigenaarschap en Data Lineage blijft onduidelijk of afwijkingen in rapportages voortkomen uit procesverschillen of uit inconsistenties in de onderliggende data. Dit vertraagt de beoordeling van cijfers en ondermijnt het vertrouwen in BI-uitkomsten.
De risico's nemen toe wanneer toegang tot gegevens en wijzigingen in de gegevensstroom niet zichtbaar zijn. Row-Level Security (RLS) kan toegang beperken tot de rijen die voor een gebruiker of rol relevant zijn, terwijl Column-Level Security (CLS) toegang tot afzonderlijke gegevensvelden kan beperken. Audit logging maakt wijzigingen en raadplegingen beter traceerbaar. Deze mechanismen lossen datakwaliteit niet op, maar maken wel duidelijker wie welke gegevens kan zien en hoe een BI-uitkomst tot stand is gekomen.
Een gerichte Proof of Concept met eigen geanonimiseerde data kan deze punten vroeg zichtbaar maken. Toets daarbij niet alleen of het dashboard de gewenste vraag beantwoordt, maar ook of belangrijke cijfers naar hun bron en transformatie zijn te herleiden en of toegangsrechten werken zoals bedoeld. Daarmee ontstaat een onderbouwde basis voor verdere uitrol, in plaats van een discussie achteraf over cijfers waarvan de herkomst niet helder is.
Praktische stappen voor het aanpakken van gefragmenteerde data
Een werkbare eerste stap is het afbakenen van één zorgproces waarvoor een dashboard daadwerkelijk gebruikt kan worden. Die afbakening bepaalt welke gegevensbronnen relevant zijn en voorkomt dat alle verspreide data tegelijk onderdeel wordt van het project. De modulaire API-laag richt zich vervolgens uitsluitend op de gegevens die voor dat proces nodig zijn. Daardoor ontstaat een overzichtelijke eerste verbinding tussen bestaande systemen en Business Intelligence, in plaats van een breed traject waarvan de waarde pas laat zichtbaar wordt.
De praktische volgorde bestaat uit drie samenhangende keuzes. Eerst krijgt het gekozen zorgproces een duidelijke grens: welke informatievraag staat centraal en welke systemen leveren daarvoor gegevens? Daarna wordt bepaald welke gegevens via de gerichte API-laag beschikbaar komen voor het dashboard. Ten slotte worden de architectuur- en standaardafspraken vastgelegd waaraan deze aansluiting moet voldoen. Neem hierin ook op welke bron eigenaar is van de gegevens, hoe definities worden beheerd en welke transformaties voor de rapportage worden toegepast.
De opbrengst van deze werkwijze zit niet alleen in de snelheid waarmee een eerste dashboard beschikbaar kan komen. De organisatie ziet ook welke uitbreiding logisch volgt en welke uitbreiding nog afhankelijk is van aanvullende afspraken. Een volgende bron of een volgend zorgproces wordt daarmee geen automatische toevoeging, maar een stap die langs dezelfde gegevensdefinities, kwaliteitscontroles en verantwoordelijkheden wordt gelegd. De gefaseerde groei van data-analyse en BI in zorginstellingen sluit bij die werkwijze aan: volwassenheid ontstaat via opeenvolgende stappen, niet doordat alle mogelijkheden gelijktijdig worden ingevoerd.
De modulaire API-laag blijft hierbij een middel, geen doel. Zij biedt ruimte om gericht te starten, terwijl de eerste fase tegelijk duidelijk maakt welke werkwijze het team nodig heeft voor beheer, validatie en uitbreiding. De concrete uitkomst is daarom tweeledig: een dashboard voor het gekozen proces én een gedeelde werkwijze voor het aansluiten van de volgende gegevensbron.
Belangrijke overwegingen voor een succesvolle BI-implementatie in de zorg
De eerste BI-release in een zorgorganisatie is pas beheersbaar wanneer de begrenzing van de gegevensstroom even serieus wordt genomen als de inhoud van het dashboard. Semantische harmonisatie houdt zorgbegrippen tussen betrokken systemen vergelijkbaar, terwijl een gerichte API-laag de eerste informatie voor één proces beschikbaar maakt. Voor persoonsgegevens en zorggegevens moeten ook de toepasselijke eisen uit de AVG en de informatiebeveiligingsnorm NEN 7510 in de inrichting worden meegenomen. Daarmee krijgt de implementatie een technische, semantische en organisatorische grens.
Maak toegang en herleidbaarheid onderdeel van de eerste release. Een dashboard voor een specifiek zorgproces heeft alleen blijvende waarde wanneer duidelijk is welke gegevens erin staan, wie ze mag raadplegen en hoe de uitkomst naar de bron is terug te volgen. RLS en CLS kunnen helpen om toegang op rij- en veldniveau te beperken. Data Lineage en audit logging ondersteunen vervolgens de traceerbaarheid van gegevens en wijzigingen binnen de BI-keten.
Deze inrichting sluit aan op de noodzaak om zorggegevens zorgvuldig te verwerken. In plaats van beveiliging pas toe te voegen nadat een rapportage werkt, worden toegangsrechten, logging en herleidbaarheid meegenomen in de gegevensstroom zelf. Zo kan het team bij een afwijkende uitkomst niet alleen de definitie controleren, maar ook nagaan welke bron en transformatie eraan voorafgingen.
Bij uitbreiding blijft de centrale vraag daarom niet alleen of een nieuwe koppeling technisch mogelijk is, maar ook of deze dezelfde toegangs-, traceerbaarheids- en architectuurafspraken kan volgen. Dat houdt de groei van BI beheersbaar zonder de bruikbaarheid van de eerste inzichten te verliezen.