
Een startup kan een AI-PoC pas verantwoord opschalen wanneer vooraf vastgelegde acceptatiecriteria op een vaste, representatieve evaluatieset herhaaldelijk worden gehaald, onzekerheid zichtbaar naar menselijke review gaat en de applicatie ongeldige of afwijkende output vóór verdere verwerking tegenhoudt. Blijven kwaliteit, controleerbaarheid, uitzonderingen en de benodigde reviewlast daarbij niet beheersbaar, dan moet de use-case worden beperkt of de productinvestering stoppen.
Kort samengevat: van AI-PoC naar productie
Een productieapplicatie vraagt meer dan een overtuigende demo: de gekozen workflow moet onder herhaalbare omstandigheden meetbaar, controleerbaar en onderzoekbaar blijven.
- Meet kwaliteit tegen vooraf bepaalde, representatieve gevallen en herhaal die toets bij wijzigingen aan prompts of externe AI-diensten.
- Beoordeel niet alleen of antwoorden juist lijken, maar ook of dubbelzinnige invoer en onzekerheid als uitzondering zichtbaar worden.
- Kies gericht tussen verdere verbetering van AI-gedrag en applicatiecontroles die bepalen welke output daadwerkelijk mag doorwerken.
- Maak uitkomsten voor gebruikers toetsbaar aan de onderliggende bron, zodat zij kunnen bevestigen, corrigeren of afwijzen.
- Leg vooraf vast welke resultaten automatisch mogen doorstromen en welke altijd menselijke beoordeling vereisen.
- Bewaar per verwerking de samenhang tussen gebruikte instructie, duur, controles en eventuele vervolgwijzigingen, zodat afwijkingen achteraf te reconstrueren zijn.
Wanneer kan een AI-proof of concept verder dan een demo?
Een AI-proof of concept kan verder dan een demo wanneer dezelfde kwaliteit herhaalbaar blijkt op een vaste evaluatieset. Zo'n set wordt ook wel een golden evaluation set genoemd: een vaste verzameling representatieve gevallen waarmee u wijzigingen consequent langs dezelfde meetlat legt. Een overtuigend antwoord op één gekozen voorbeeld is daarvoor niet genoeg. De vraag is of het systeem bij een volgende beoordeling van dezelfde, vooraf bepaalde gevallen nog steeds uitkomsten levert die binnen uw acceptatie passen.
Een demo laat vooral zien dat een idee technisch mogelijk lijkt. Iemand kiest een gunstige invoer, stelt een vraag en ziet een bruikbaar antwoord. Dat kan een goede eerste aanwijzing zijn. Maar een productieapplicatie verwerkt niet alleen zorgvuldig gekozen voorbeelden. Daarin komen dezelfde typen documenten, vragen of gegevens telkens opnieuw terug, naast varianten die minder netjes, onvolledig of onverwacht zijn.
Maak daarom van de PoC een toetsbare proef. Leg de evaluatieset vast en bepaal per geval wat een bruikbare uitkomst is. Dat kan betekenen dat de AI een juiste classificatie geeft, de juiste gegevens extraheert, of juist aangeeft dat de invoer niet betrouwbaar genoeg is voor automatische verwerking. Pas de set niet tussentijds aan om de uitkomst beter te laten lijken; juist de stabiliteit ervan maakt vergelijking mogelijk.
Herhaal de beoordeling wanneer u de PoC wijzigt en wanneer de externe AI-dienst verandert. Externe LLM-providers kunnen modelgewichten en systeeminstructies bijwerken onder zwevende versielabels. Daardoor kan kwaliteit geleidelijk afnemen zonder dat uw eigen applicatiecode gewijzigd is: een vorm van semantic drift. Geautomatiseerde regressietesten op dezelfde evaluatieset maken die verschuiving zichtbaar voordat u een verandering als normaal gedrag accepteert.
Dit is geen universele grens voor nauwkeurigheid. De passende acceptatie hangt af van de specifieke workflow en van wat een fout daar veroorzaakt. Het onderscheid is wel helder: een demo laat zien dat een uitkomst mogelijk is; een PoC die verdere bouw rechtvaardigt, laat zien dat u kwaliteit herhaald kunt meten en afwijkingen kunt herkennen. Pas dan ontstaat een basis om de AI-stap in een Laravel-applicatie verder uit te werken, zonder de demo als bewijs voor blijvende kwaliteit te behandelen.
Waarom een overtuigend AI-antwoord toch niet veilig door kan naar de workflow
Exception masking ontstaat wanneer een AI-systeem bij ambigue invoer niet laat zien dat meerdere uitleggen mogelijk zijn, maar één uitleg als een gewoon, stellig antwoord presenteert. Ambigue invoer kan bestaan uit een vraag of gegeven dat op meer dan één manier gelezen kan worden. Het risico zit niet alleen in een inhoudelijk onjuist antwoord. De onzekerheid die aan dat antwoord voorafging, is voor de rest van het proces niet zichtbaar.
Daardoor krijgt een onzekere uitkomst dezelfde vorm als een betrouwbare uitkomst. Een applicatie, medewerker of vervolgstap ziet geen onderscheid tussen een antwoord dat voldoende basis heeft en een antwoord waarvoor het model een interpretatie heeft ingevuld. Als er geen expliciete fallback wordt geactiveerd, verschijnt de afwijking ook niet als uitzondering. Zij kan worden behandeld als reguliere invoer, terwijl de onjuiste interpretatie al aan het begin van de verwerking is ontstaan.
Dat wordt risicovol zodra de AI-uitkomst niet op zichzelf staat, maar gegevens aanvult, een vervolgactie beïnvloedt of als invoer dient voor een operationeel kernsysteem. De fout kan dan doorwerken zonder dat het moment waarop de invoer dubbelzinnig was nog herkenbaar is. Een plausibel geformuleerd antwoord maakt dit lastiger: de formulering geeft geen zichtbaar teken dat het systeem onvoldoende basis had om één betekenis met zekerheid te kiezen.
De relevante vraag voor de workflow is daarom niet of elk ambigu geval tot een fout leidt, maar of onzekerheid nog zichtbaar is voordat de uitkomst gevolgen krijgt. Kan dat niet, dan krijgt een schijnbaar normaal antwoord een status die het niet heeft verdiend.
Wanneer verdere promptiteratie plaats moet maken voor controles in Laravel
De keuze gaat niet over een laatste procentpunt alleen, maar over welk risico u op dat moment kunt beïnvloeden. Promptiteratie verbetert het gedrag van de AI in de proof of concept; hardening in Laravel bepaalt welke uitkomsten de applicatie onder vaste voorwaarden verwerkt.
| Aspect | Verdere promptiteratie | Hardening in Laravel-applicatiesoftware |
|---|---|---|
| Doel van de investering | De AI beter laten aansluiten op de afgebakende taak door prompts te verfijnen. | Vaste controles toevoegen rond de verwerking van AI-output in de workflow. |
| Waar u op stuurt | De kwaliteit van het antwoord binnen de prototypeomgeving. | De voorwaarden waaronder een antwoord in de applicatie mag worden gebruikt. |
| Type foutbeheersing | Vermindert fouten die voortkomen uit de interpretatie van de AI. | Deterministische validatielagen geven bij dezelfde invoer steeds hetzelfde oordeel. Zij kunnen output tegenhouden wanneer die niet aan vooraf bepaalde regels voldoet. |
| Rol van database-cross-checks | De database kan context leveren voor het antwoord, maar staat niet centraal in de iteratie. | Database-cross-checks leggen AI-output naast gegevens die al in het systeem aanwezig zijn voordat de workflow verdergaat. |
| Wanneer deze route passend is | Als de PoC nog onvoldoende laat zien hoe de AI de beoogde taak uitvoert. | Als de PoC voldoende inzicht geeft in het gedrag en bekende risico's door vaste regels of bestaande gegevens kunnen worden begrensd. |
| Beperking | Een betere prompt voegt geen applicatieregels of gegevenscontrole toe. | Applicatiecontroles verbeteren niet vanzelf de inhoudelijke kwaliteit van de AI-uitkomst; toetsing van het model blijft een afzonderlijk onderdeel. |
| Beslisvraag | Levert een volgende promptaanpassing aantoonbaar betere uitkomsten op voor de afgebakende taak? | Welke uitkomsten kan Laravel pas verwerken nadat vaste regels en databasegegevens zijn gecontroleerd? |
Kan een gebruiker de AI-uitkomst zelf controleren?
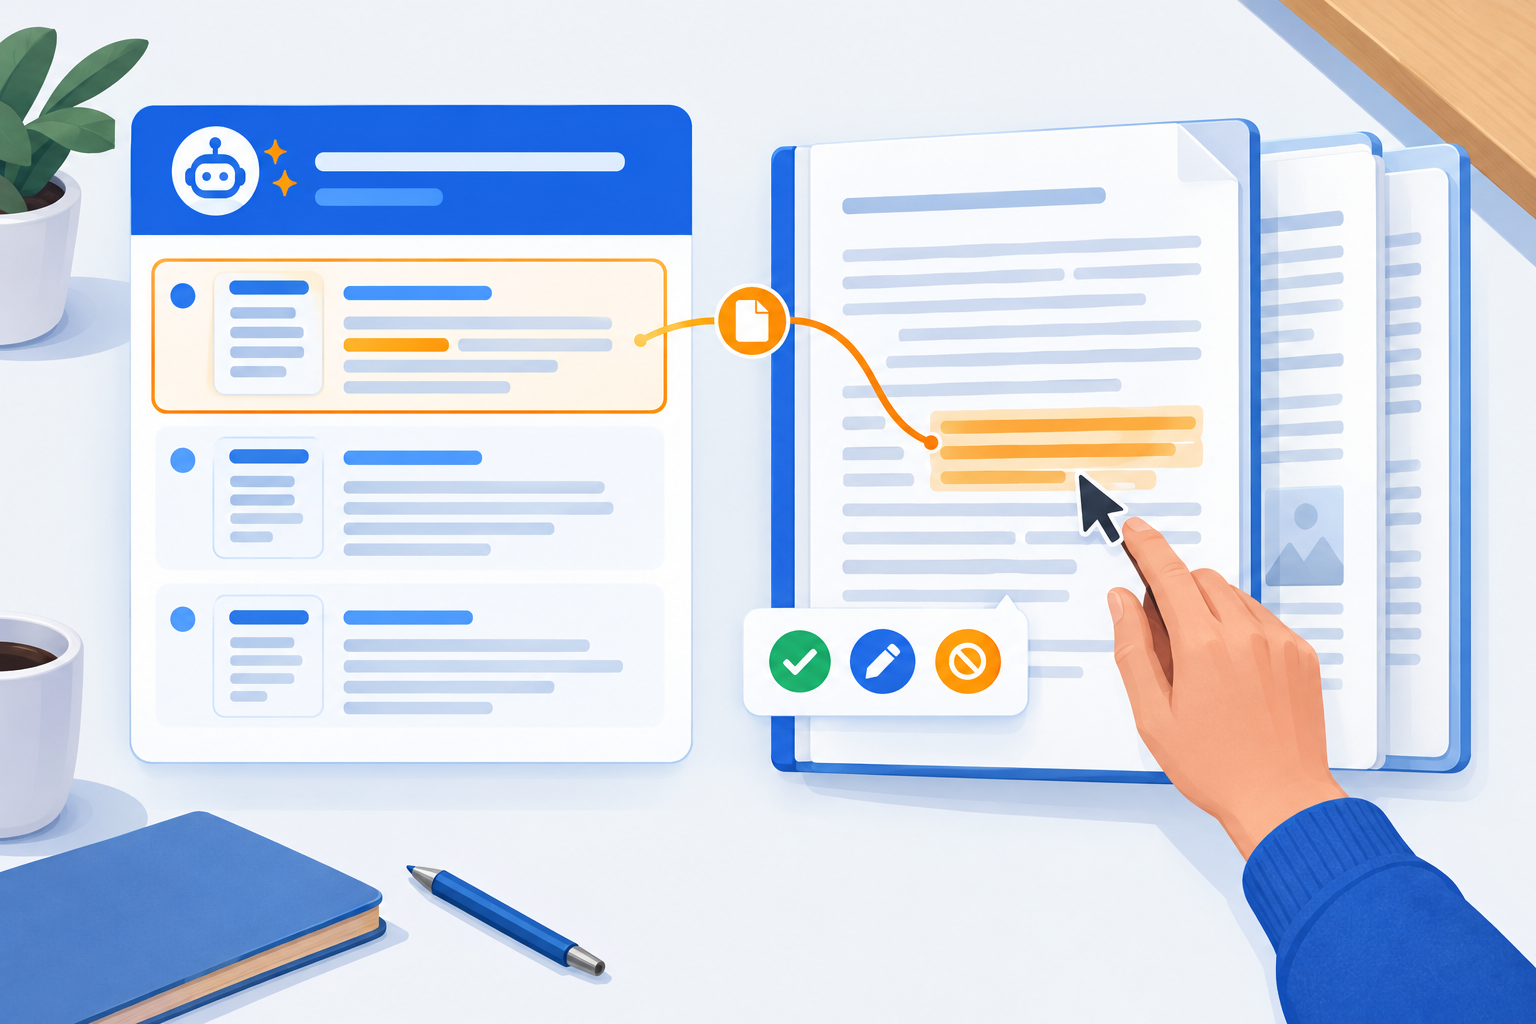
Neem verifieerbaarheid op als afzonderlijk onderdeel van uw scorecard. Een uitkomst is beter controleerbaar wanneer de gebruiker niet alleen een conclusie ziet, maar ook direct kan teruggaan naar het brondocument, het paginanummer en de passage waarop die conclusie rust. Dat maakt de uitkomst bespreekbaar in de workflow, in plaats van iets dat alleen op vertrouwen kan worden geaccepteerd.
| Scorecardvraag | Controleerbare uitkomst | Ondoorzichtige uitkomst |
|---|---|---|
| Waar komt de extractie of conclusie vandaan? | De uitkomst bevat een directe, klikbare verwijzing naar het brondocument. De gebruiker kan de herkomst openen zonder zelf te hoeven zoeken. | De uitkomst noemt geen bron. De gebruiker ziet alleen de formulering van de AI en moet zelf achterhalen waarop die gebaseerd kan zijn. |
| Kan de gebruiker de precieze context vinden? | De verwijzing bevat een paginanummer. Daarmee wordt duidelijk op welke plek in het document de relevante informatie staat. | De gebruiker krijgt hooguit een algemene verwijzing naar een verzameling documenten, of helemaal geen aanwijzing waar de informatie is gevonden. |
| Is zichtbaar welk stuk tekst de uitkomst ondersteunt? | De relevante passage is gemarkeerd. De gebruiker kan de AI-uitkomst naast de bron leggen en zien of de interpretatie past bij de tekst. | De gebruiker leest een conclusie zonder de onderliggende passage. Daardoor is niet direct zichtbaar of de AI details heeft weggelaten, verkeerd heeft gelezen of te ver heeft doorgeredeneerd. |
| Wat kan de gebruiker doen bij twijfel? | De gebruiker kan de bron raadplegen en de uitkomst bevestigen, corrigeren of naast zich neerleggen. De AI werkt dan als verifieerbare assistent. | Twijfel leidt tot handmatig zoekwerk of tot blind vertrouwen. De uitkomst blijft een moeilijk te beoordelen tussenstap in de workflow. |
| Wat toetst u in de PoC? | Toets of elke relevante extractie of conclusie de juiste bron, pagina en gemarkeerde passage teruggeeft. | Toets niet alleen of het antwoord overtuigend klinkt. Zonder controlecontext blijft een goede formulering onvoldoende bewijs dat gebruikers de uitkomst kunnen beoordelen. |
Welke uitkomst mag door, en welke gaat naar menselijke review?
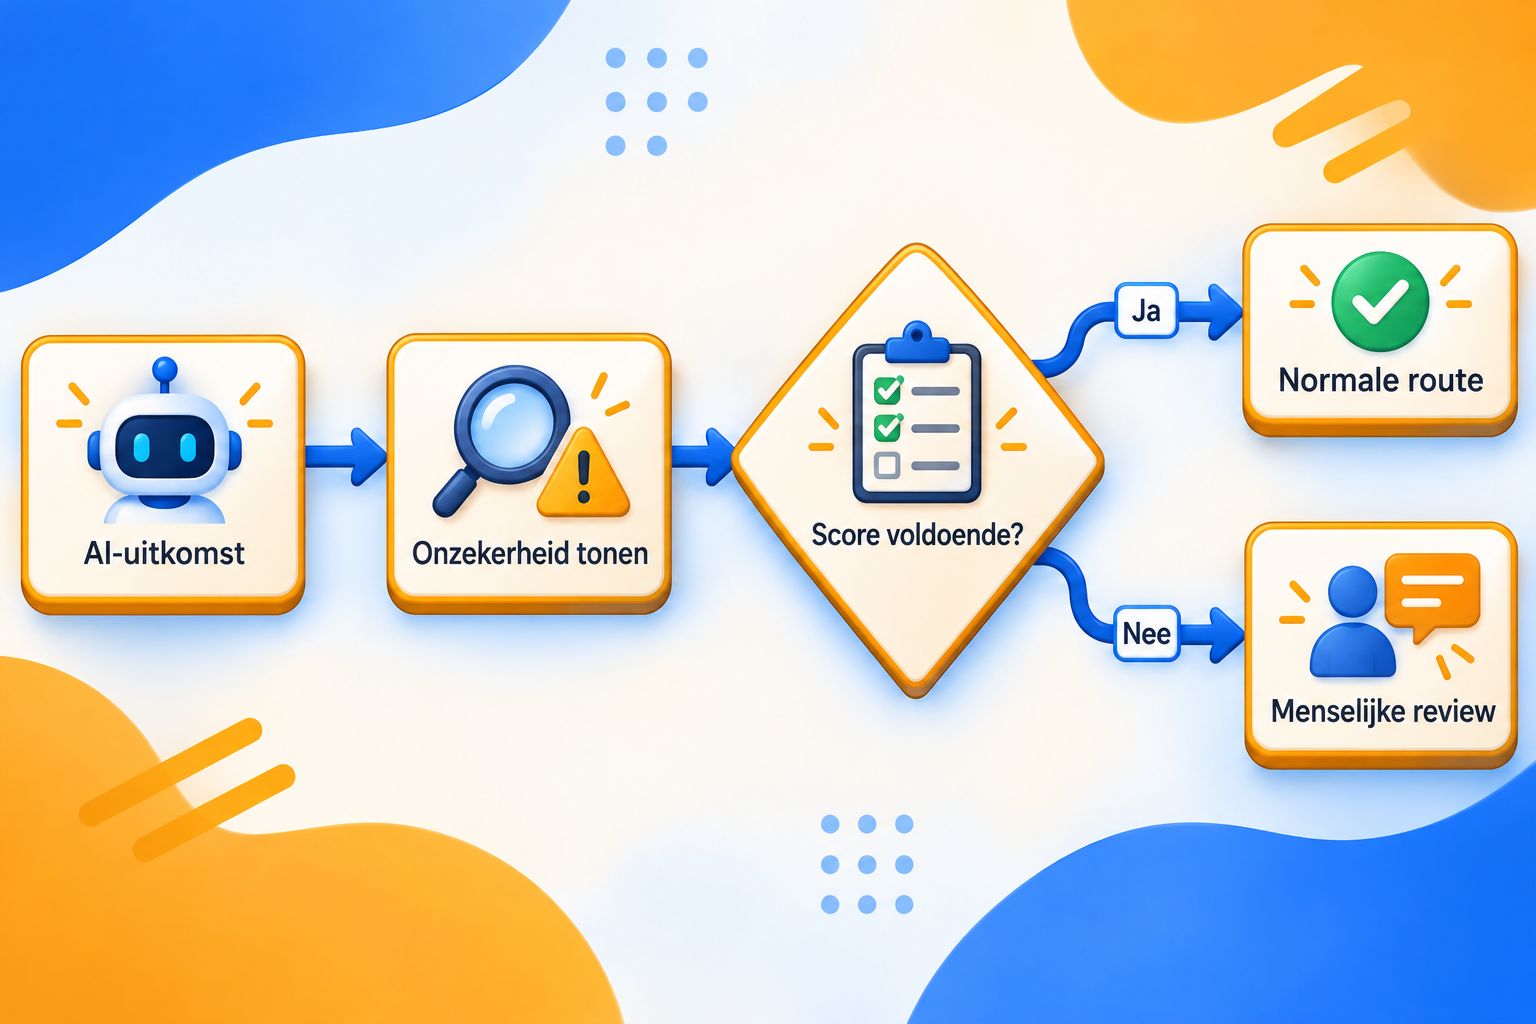
Leg vóór de volgende test vast wanneer een AI-uitkomst automatisch door mag en wanneer een medewerker hem beoordeelt. De regel bestaat uit een vooraf bepaalde acceptatiedrempel, zichtbare onzekerheid en een automatische route naar menselijke review. Zo wordt onzekerheid een herkenbare procesuitkomst, geen stilzwijgende aanname.
- Bepaal de acceptatiedrempel vooraf. Koppel de drempel aan één afgebakende workflow en leg vast welke uitkomsten u binnen die workflow zonder menselijke beoordeling accepteert. De drempel is geen algemene kwaliteitsnorm voor alle AI-toepassingen. Hij geeft aan vanaf welk punt deze specifieke uitkomst voldoende basis heeft voor de gekozen automatische stap.
- Leg ook een grens voor de reviewlast vast. Een acceptatiedrempel is pas operationeel wanneer u vooraf bepaalt hoeveel uitkomsten naar menselijke beoordeling mogen gaan. U kunt bijvoorbeeld toetsen of de gekozen workflow onder een grens van 3,0% handmatige review blijft; past die norm niet bij de risico's of beschikbare capaciteit, dan kiest u bewust een andere grens. Zo wordt de reviewlast een meetbare voorwaarde voor opschaling.
- Behandel de drempel als een beslisregel, niet als een cosmetische score. Een betrouwbaarheidsscore krijgt pas betekenis wanneer de applicatie er een consequentie aan verbindt. Boven de vastgelegde drempel volgt de normale route. Onder die drempel volgt geen automatische afhandeling alsof de uitkomst zeker is.
- Maak onzekerheid expliciet zichtbaar. Het prototype moet kunnen aangeven: “ik weet het niet zeker”. Daarmee ziet de gebruiker dat de AI geen definitieve uitkomst aanbiedt. Deze expliciete onzekerheid voorkomt dat een twijfelachtige interpretatie dezelfde status krijgt als een uitkomst met voldoende vertrouwen.
- Activeer menselijke review automatisch. Wanneer de betrouwbaarheidsscore onder de vooraf vastgelegde acceptatiedrempel valt, gaat de uitkomst naar een menselijke review-workflow.[1][2] De medewerker beoordeelt dan de uitzondering in plaats van dat de workflow de uitkomst zonder tussenstap verwerkt.
- Controleer de volledige route. Kijk niet alleen of het model een lage betrouwbaarheidsscore kan geven, maar ook of die score zichtbaar is, de review daadwerkelijk wordt geactiveerd en de uitkomst niet tegelijk langs een andere automatische route doorwerkt. De waarde zit in de samenhang tussen beoordeling, fallback en menselijke beslissing.
- Gebruik de uitkomsten om de reviewlast te beoordelen. Houd in de proef bij welke gevallen onder de drempel belanden en waarom. Daarmee wordt zichtbaar of de gekozen workflow voldoende handmatige controle vraagt en of de uitzonderingen herkenbaar zijn voor de mensen die ze behandelen.
Wat moet je per AI-transactie kunnen terugvinden?
Per AI-transactie hoort de volledige keten van vraag tot doorwerking terug te vinden te zijn. OpenTelemetry kan helpen om die context gestandaardiseerd te monitoren en te loggen. Dat maakt onderzoek mogelijk wanneer een uitkomst later vragen oproept of onverwacht in een volgende stap is gebruikt.[3]
- Welke promptversie hoort erbij?
Leg vast welke versie van de prompt bij de individuele transactie is gebruikt. Zonder die context is het lastig te onderscheiden of een afwijkende uitkomst voortkomt uit de invoer of uit een wijziging in de instructie aan het model. - Waarom registreert u tokenconsumptie?
Tokenconsumptie hoort bij dezelfde transactiecontext. Daarmee blijft zichtbaar hoeveel modelgebruik een specifieke verwerking met zich meebracht. Het is geen losse kosteninschatting, maar een gegeven dat naast de betreffende uitkomst en verwerking terug te vinden moet zijn. - Wat zegt inferentielatency?
Registreer de inferentielatency per transactie. Dit toont hoeveel tijd de modelstap voor die specifieke verwerking nam. Bij een afwijkende gebruikerservaring of vertraagde workflow kunt u de modelstap daardoor onderscheiden van andere delen van de keten. - Welke validatieresultaten legt u vast?
Bewaar het resultaat van de controles die bij de AI-uitkomst horen. Daardoor ziet u achteraf niet alleen wat de AI opleverde, maar ook hoe die uitkomst door de applicatie is beoordeeld voordat de volgende stap plaatsvond. - Waarom horen database-mutaties in hetzelfde overzicht?
Een AI-transactie eindigt niet bij het antwoord van het model wanneer dat antwoord gegevens verder in de workflow beïnvloedt. Leg daarom ook de downstream database-mutaties vast. Zo blijft herleidbaar welke verandering in de database bij welke promptversie, latency en validatie-uitkomst hoort. - Wat levert die samenhang op?
U kunt een individuele uitkomst reconstrueren als één keten: gebruikte prompt, modelgebruik, duur, validatie en eventuele mutatie in de database. Dat is concreter dan een losse foutmelding of alleen een eindresultaat. Logging voorkomt geen incidenten, maar zonder samenhangende transactiecontext blijft het onderzoek naar een afwijking onvolledig.
Deze registratie ondersteunt ook een deterministische fallback: wanneer controles een uitkomst tegenhouden, moet achteraf zichtbaar zijn welke regel dat deed en welke route vervolgens is gekozen.
Verder bouwen is pas verdedigbaar als de onzekerheid beheersbaar blijft
Het oordeel is helder: een grotere investering in een Laravel-productieapplicatie is alleen verdedigbaar wanneer de AI-uitkomsten binnen de gekozen workflow controleerbaar blijven en een fout niet ongemerkt verder kan worden verwerkt. De evaluatieset, acceptatiedrempel en fallback moeten daarbij niet alleen bestaan, maar in de praktijk samenhangen.
Dat is ook een financiële grens. Wie verder bouwt zonder voldoende bewijs, financiert niet alleen de productieapplicatie, maar mogelijk ook het herstelwerk dat ontstaat wanneer onjuiste output al onderdeel van het proces is geworden. Medewerkers moeten dan achteraf extra controleren, fouten corrigeren en werkwijzen aanpassen rond een AI-stap die juist werk had moeten ondersteunen. De kosten zitten dus niet uitsluitend in de bouw, maar in de blijvende belasting van een workflow waarin onbetrouwbare uitkomsten al invloed hebben gekregen.
Operationeel telt vooral of afwijkingen zichtbaar en onderzoekbaar blijven voordat zij gevolgen hebben voor vervolgstappen. De eerder vastgelegde controles, menselijke beoordeling en vastlegging van de verwerking vormen samen de grens tussen een beheersbare AI-toepassing en een resultaat waarop de organisatie noodgedwongen moet vertrouwen. Als die grens niet aantoonbaar standhoudt, voorkomt stoppen of het opnieuw afbakenen van de use-case dat onzekerheid in de applicatie wordt vastgelegd. Dat is geen mislukking van de proof of concept, maar een onderbouwde keuze om geen productinvestering te doen voordat de foutlast en benodigde controlewerkzaamheden beheersbaar zijn.
Leg de use-case en meetlat vast vóór de volgende bouwbeslissing
Plan een gesprek van een half uur over het proces, de beoogde use-case en de meetlat die vooraf nodig is voor een zorgvuldige bouwbeslissing. Samen kunt u scherpstellen welk probleem een PoC moet toetsen, welke signalen als voldoende gelden en welke randvoorwaarden bepalend zijn. De uitkomst kan zijn dat verdere uitwerking kansrijk is, maar ook dat deze nu niet passend is. Juist die duidelijkheid helpt om de volgende stap bewust te kiezen.