
Om AI-oplossingen binnen een organisatie te schalen zonder bestaande systemen te overbelasten, scheidt u AI-verwerking van transactionele kernsystemen. Asynchrone taakwachtrijen en afzonderlijke AI-diensten zorgen ervoor dat zware taken buiten het primaire proces worden verwerkt. Beperk daarnaast schrijfrechten, leg toegangsrechten zorgvuldig vast en toets de integratie eerst in een gecontroleerde omgeving. Zo kan AI-capaciteit groeien zonder de stabiliteit van kritieke bedrijfsprocessen in gevaar te brengen.
AI-schaalvergroting zonder systeemoverbelasting
Een schaalbare AI-integratie begint met een duidelijke scheiding tussen het primaire bedrijfsproces en aanvullende AI-verwerking. De architectuur moet niet alleen capaciteit kunnen opvangen, maar ook voorkomen dat fouten, vertragingen of onjuiste uitkomsten direct doorwerken in bestaande systemen.
- Gebruik asynchrone taakwachtrijen voor AI-taken die geen directe respons vereisen.
- Plaats AI-integraties in afzonderlijke diensten, zodat storingen beperkt blijven tot de AI-laag.
- Beperk toegang tot bedrijfsdata met duidelijke autorisaties en gescheiden rollen.
- Toets de gekozen integratie en acceptatiecriteria eerst in een gecontroleerde Proof of Concept-omgeving.
Belangrijke architecturale keuzes voor AI-schaalvergroting
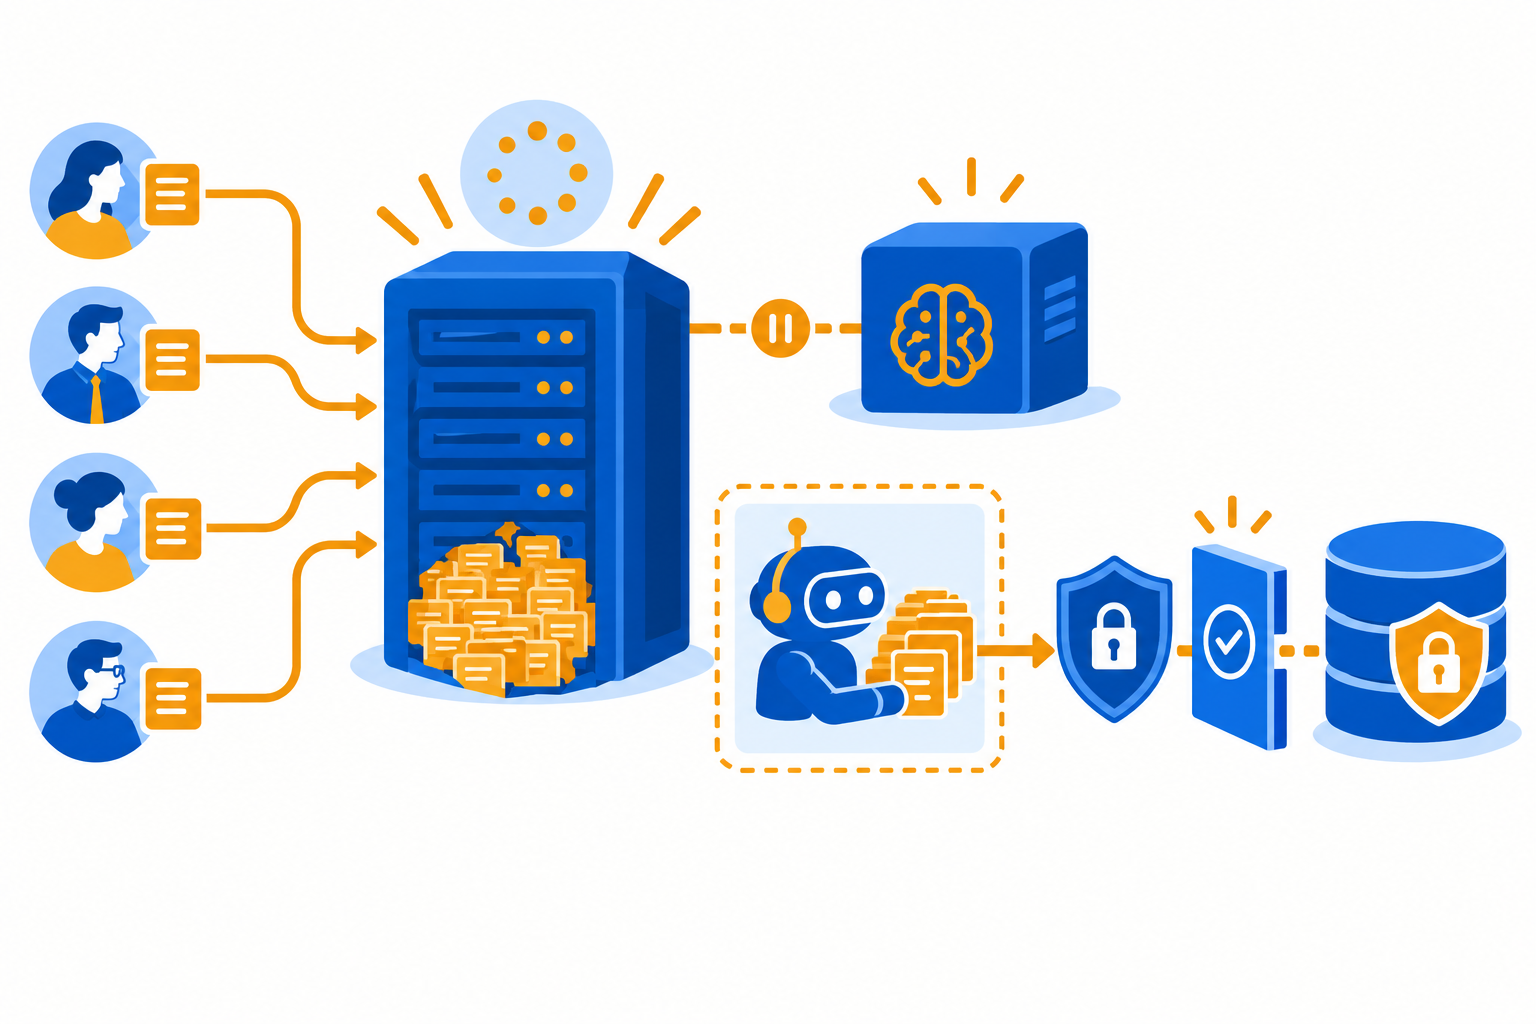
In organisaties met legacy-systemen is het verstandig om zware AI-processen niet te laten concurreren met transactionele kernsystemen. Asynchrone taakwachtrijen bieden hiervoor een bruikbare scheiding: AI-inferentie en dataverrijking worden als opdrachten in een wachtrij geplaatst en door aparte werkers verwerkt. De kernapplicatie hoeft dan niet te wachten op een AI-uitkomst, zolang de bedrijfsactie geen directe AI-respons vereist. Bij piekbelasting kan alleen de verwerkingscapaciteit van deze werkers worden uitgebreid, zonder dat de transactionele laag dezelfde belasting hoeft te dragen.
Microservices vormen een tweede architecturale grens. Door AI-functionaliteit als afzonderlijke dienst te positioneren, blijven prestatieproblemen of storingen in de AI-laag beter afgebakend van de kernapplicatie. Dat vraagt beheer van de koppeling, foutafhandeling en versieverschillen tussen systemen, maar voorkomt dat de bestaande toepassing volledig afhankelijk wordt van één AI-component. Voor legacy-omgevingen maakt dit een stapsgewijze invoering mogelijk: de AI-dienst draait naast de monoliet in plaats van er direct onderdeel van te worden.
Ook de gegevensgrens verdient aandacht. Wanneer AI-componenten gevoelige bedrijfsdata gebruiken, bijvoorbeeld via semantische zoeklagen, moeten autorisaties in de AI-laag aansluiten op die van het bronsysteem. Row-Level Security (RLS) of een vergelijkbare scheiding kan helpen voorkomen dat zoekresultaten gegevens tonen die een medewerker in de bronapplicatie niet mag inzien. Dit beperkt beveiligingsrisico’s en is relevant wanneer persoonsgegevens onder de AVG worden verwerkt. De afbakening van toegangsrechten hoort daarom bij dezelfde ontwerpkeuze als het isoleren van de AI-werkbelasting.
Hoe AI veilig opschalen zonder systeemoverbelasting
Naast capaciteitsverdeling is de route van een AI-uitkomst naar een bedrijfswijziging bepalend. Een afzonderlijke AI-dienst beschermt de kernapplicatie niet wanneer die dienst zelfstandig mutaties kan uitvoeren buiten de bestaande bedrijfsregels om. Houd daarom het onderscheid tussen lezen, beoordelen en muteren expliciet: AI kan een voorstel of analyse leveren, terwijl de kernapplicatie de validatie en verwerking van een definitieve wijziging behoudt.
Directe databaseschrijfrechten voor een autonoom AI-component vergroten het risico op foutieve mutaties. Wanneer invoer verkeerd wordt geïnterpreteerd en API- of bedrijfsregels worden omzeild, kunnen bijvoorbeeld onjuiste wijzigingen in een centrale voorraadadministratie doorwerken naar voorraadtelling en facturatie. Naarmate het gebruik groeit, neemt ook de mogelijke omvang van zulke fouten toe.
Leg daarom vast welke acties de AI-component mag uitvoeren, welke wijzigingen menselijke beoordeling vereisen en welke altijd via de bestaande applicatielaag moeten lopen. Een audit trail en data lineage maken daarbij zichtbaar welke brongegevens zijn gebruikt, welke AI-uitkomst is geproduceerd en hoe een wijziging uiteindelijk is verwerkt. Dit ondersteunt onderzoek naar afwijkingen zonder van de AI-component een tweede, onbeheerde ingang naar bedrijfsdata te maken.
Deze werkwijze sluit aan bij een incrementele aanpak rond legacy-systemen: AI-functionaliteit wordt naast de bestaande omgeving geplaatst, terwijl de bestaande toepassing leidend blijft in het primaire proces.
Problemen bij het schalen van AI-oplossingen
Ook met een gescheiden architectuur kunnen problemen ontstaan wanneer de operationele randvoorwaarden ontbreken. Een wachtrij voorkomt bijvoorbeeld geen achterstand als de instroom structureel groter is dan de beschikbare verwerkingscapaciteit. Zonder inzicht in wachttijd, foutmeldingen en mislukte opdrachten kan een vertraging pas zichtbaar worden wanneer gebruikers merken dat resultaten uitblijven. Monitoring van de doorlooptijd, foutafhandeling en capaciteit is daarom nodig om op te schalen voordat de achterstand het bedrijfsproces raakt.
Een tweede aandachtspunt is eigenaarschap. AI-integraties raken vaak meerdere teams: het team dat het bronsysteem beheert, het team dat de AI-dienst onderhoudt en de proceseigenaar die de uitkomsten gebruikt. Als onduidelijk is wie een fout onderzoekt, een koppeling terugdraait of een gewijzigde bedrijfsregel beoordeelt, blijft een technische scheiding onvoldoende. Leg daarom verantwoordelijkheden en de terugvalroute vast voordat de toepassing breder wordt gebruikt.
Een gecontroleerde Proof of Concept biedt ruimte om deze punten te toetsen op eigen bedrijfsdata. Bepaal vooraf welke uitkomsten acceptabel zijn, welke verwerkingstijd past bij het proces en wanneer een resultaat niet automatisch mag worden gebruikt. De PoC maakt daarmee niet alleen de kwaliteit van AI-uitkomsten zichtbaar, maar ook of de gekozen integratie, beheerafspraken en toegangsgrenzen geschikt zijn voor verdere opschaling.
Praktische toepassingen voor veilige AI-schaalvergroting
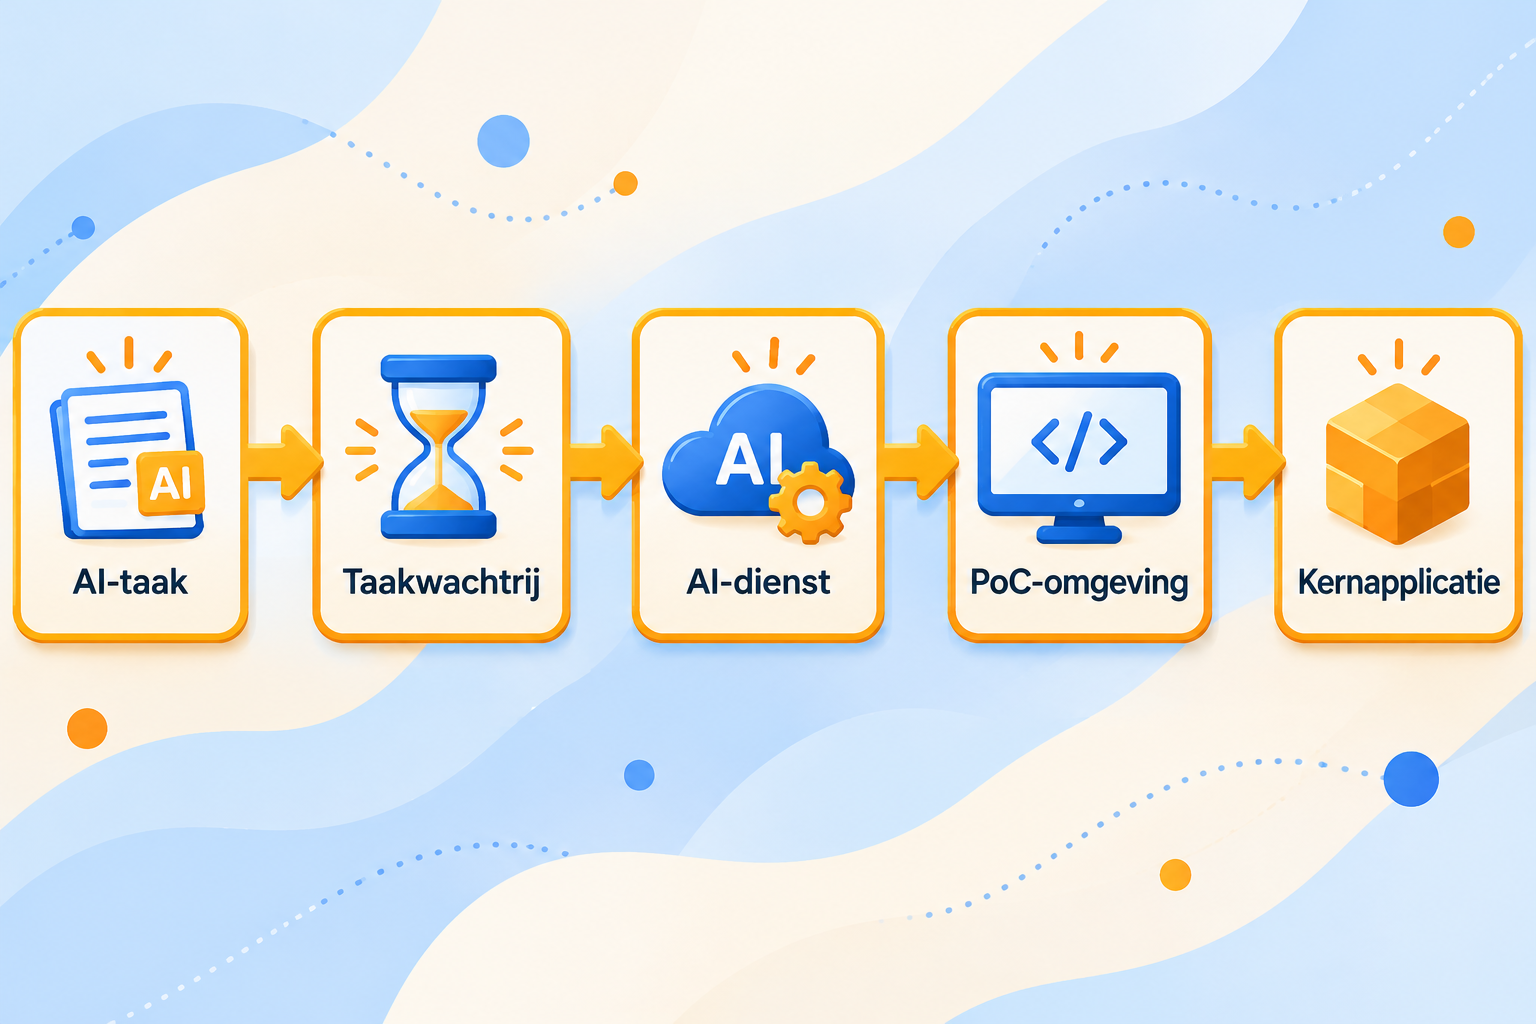
Bij documentverwerking, analyses of classificatietaken kan de kernapplicatie een opdracht aanbieden aan de asynchrone verwerkingslaag. De gebruiker kan verder met het primaire proces, terwijl de AI-dienst het resultaat verwerkt zodra capaciteit beschikbaar is. Het resultaat wordt vervolgens als voorstel, verrijking of status teruggegeven aan de bestaande toepassing in plaats van rechtstreeks in brontabellen te worden geschreven.
Voor processen met bedrijfsimpact is een beoordelingsstap passend. De AI-dienst kan bijvoorbeeld een mutatievoorstel aanleveren, waarna de kernapplicatie controleert of verplichte gegevens aanwezig zijn, autorisaties kloppen en bestaande bedrijfsregels worden gevolgd. Zo blijft de software die het proces beheert ook verantwoordelijk voor de definitieve verwerking.
Maak daarnaast per gegevensstroom inzichtelijk welke brongegevens de AI-dienst ontvangt, waar resultaten worden opgeslagen en wie die resultaten mag inzien. Die data lineage helpt bij het onderzoeken van afwijkende uitkomsten en bij het beheren van toegangsrechten. In combinatie met een audit trail ontstaat een beheersbaar schaalpad: AI-capaciteit kan worden uitgebreid, terwijl mutaties en toegang controleerbaar blijven.
Belangrijke overwegingen voor AI-schaalvergroting
De kwaliteit van een schaaltraject blijkt minder uit de vraag of AI technisch kan worden aangesloten dan uit de onderbouwing van de grens tussen de nieuwe toepassing en de bestaande operatie. Die onderbouwing begint vóór bouw en integratie, bij een analyse van de afhankelijkheden die bepalen waar belasting, gegevens en bedrijfslogica samenkomen.
- Een analyse van database- en API-afhankelijkheden maakt zichtbaar welke koppelingen de AI-toepassing raakt en waar een extra verwerkingspad de bestaande operatie kan beïnvloeden. Gebruik die analyse om vast te leggen welke taken buiten de transactionele kern kunnen draaien, welke gegevens de AI-dienst werkelijk nodig heeft en via welke applicatielaag wijzigingen terugkeren. Controleer daarbij ook of autorisaties uit het bronsysteem consequent worden doorgegeven aan de AI-laag. De resultaten van de PoC kunnen vervolgens worden gebruikt om capaciteitsgrenzen, verantwoordelijkheden en acceptatiecriteria definitief te maken. Zonder inzicht in deze afhankelijkheden kan een uitbreiding kosten of verstoringen veroorzaken in de kernoperatie, terwijl de AI-toepassing zelf ogenschijnlijk blijft functioneren.